

BigHub blog – čtěte, objevujte a nechte se inspirovat.
Novinky z oboru, rozhovory, technologické zajímavosti a spousta dalších přínosných informací.
10 signálů, že vaše data nejsou připraveny na AI (a jak každou z nich vyřešit)
Firmy, které dnes z AI získávají největší hodnotu, nemají nutně lepší modely. Mají lepší datové základy.
Je dobré si přiznat, jak výrazně se samotný model propadl na seznamu věcí, které rozhodují o úspěchu AI projektu. Nejnovější jazykové a embeddingové modely jsou dnes dostupné prakticky všem a působivé demo lze postavit během několika dní.
Demo je jednoduché. Systém za ním už ne. Rozdíl mezi proof of conceptem a řešením, kterému může velká firma skutečně důvěřovat, proto většinou není v modelu. Rozhoduje, jestli se AI může opřít o data, která lze používat opakovaně, bezpečně a konzistentně.
Napříč více než 500 projekty pro více než 100 velkých firem od roku 2016 se opakovaně setkáváme se stejnými varovnými signály. Spadají do tří oblastí: zda lze věřit samotným datům, zda je současná architektura dokáže správně poskytovat a zda AI umí bezpečně pracovat s firemními znalostmi. Tady je deset nejdůležitějších a konkrétní doporučení, jak je řešit.
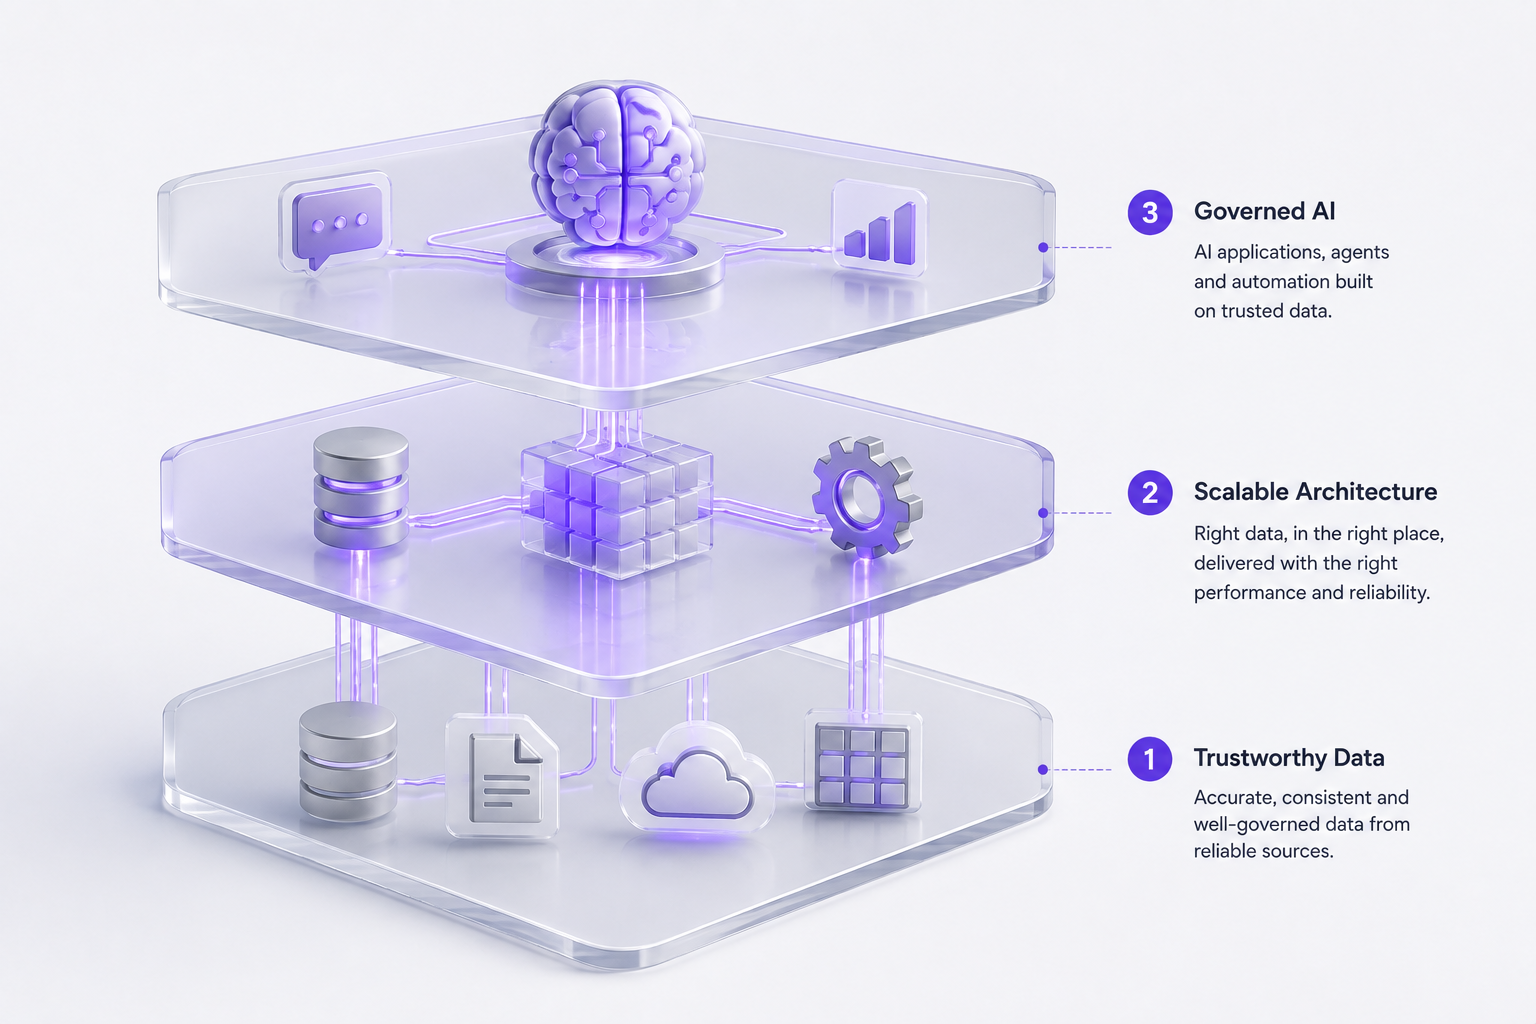
Nejdřív musíte věřit vlastním číslům
Ještě před architekturou a modely si položte jednodušší otázku: věří lidé ve vaší firmě číslům, se kterými už dnes pracují? Často ne. A AI tento problém velmi rychle odhalí.
1. Stejné KPI znamená pro každý tým něco jiného
Zeptejte se tří oddělení na tržby za minulý měsíc a možná dostanete tři různá čísla. Finance počítají vyfakturované tržby bez DPH, obchod pracuje s uzavřenými objednávkami a dashboard ukazuje ještě třetí hodnotu. Dlouho se s tím dalo žít, protože někdo v místnosti obvykle věděl, které číslo je v daném kontextu správné. AI asistent takový instinkt nemá. Použije definici, ke které dostal přístup. Jakmile vedení firmy dostane od stejného systému dvě protichůdné odpovědi, důvěra v něj mizí velmi rychle.
Řešení je méně technické, než se může zdát. Pro klíčové metriky stanovte jednu společnou definici a jasného vlastníka. Jakoukoli změnu definice řešte jako vědomé a komunikované rozhodnutí, ne jako úpravu, kterou si jeden tým provede sám pro sebe. Společný jazyk pro nejdůležitější KPI umožní AI spory o čísla řešit, ne vytvářet nové.
Co vidíme v praxi
Organizace se často domnívají, že mají problém s kvalitou dat.
Ve skutečnosti mají problém s konzistencí.
Data existují. Firma se prostě neshodne na tom, co znamenají.
2. Data vznikají jako reporty, ne jako datové produkty
V řadě firem data stále vznikají postaru. Někdo položí otázku, analytik vytvoří export, ručně ho vyčistí a pošle dál. Při další otázce celý proces začíná znovu. Samotný report nemusí být chybný. Problém je, že není znovu použitelný. Dva analytici tak mohou na stejnou otázku odpovědět dvěma různými čísly, aniž by bylo jasné, kdo za rozdíl odpovídá.
Přístup data jako produkt tento vztah mění. Kritický dataset už nevzniká pokaždé na objednávku, ale funguje jako dlouhodobě spravovaná služba. Má svého vlastníka, definovanou kvalitu a aktuálnost, jasný význam a plán dalšího rozvoje. Nejde o proces pro proces. Právě díky tomu se může AI zítra spolehnout na stejná data, ze kterých vycházela dnes.
3. Když se něco pokazí v datech, nikdo se to nedozví včas
Datové problémy většinou nepřicházejí s hlasitým alarmem. Feed dorazí pozdě, datová dávka se načte jen částečně nebo se nečekaně změní struktura některého pole. Dashboard přesto dál ukazuje číslo, jako by se nic nestalo.Ve světě reportingu si toho někdo dříve nebo později všimne. Ve světě AI už se mezitím chybná data mohla dostat do odpovědi zákazníkovi. Reporting dokáže pozdní data odpustit. AI ne.
První instinkt bývá monitorovat všechno. To ale většinou vede jen k záplavě alertů, které postupně všichni začnou ignorovat. Začněte datasety, na kterých závisejí vaše první AI use cases, a sledujte tři nejčastější problémy: zda data dorazila včas, zda se jejich objem výrazně neodchýlil od normálu a zda se bez upozornění nezměnila jejich struktura. Každý alert musí mít vlastníka a jednoduchý postup, co dělat dál. Monitorovat všechno vytváří šum. Monitorovat data, na kterých vaše AI skutečně závisí, vytváří důvěru.
I důvěryhodná data mohou narazit na špatnou architekturu
Řada firem si sjednotí definice a zlepší kvalitu dat, ale AI projekty přesto začnou narážet na další bariéru. AI totiž přináší typ workloadu, pro který většina současných datových systémů původně nevznikla. BI vysvětluje, co se stalo. AI stále častěji pomáhá rozhodovat o tom, co se má stát dál, a k tomu potřebuje vědět, co se děje právě teď. Právě tento rozdíl odhaluje limity architektury, které firmy dříve nemusely řešit.
Co vidíme v praxi
Firmy málokdy přestavují svou architekturu jen kvůli AI.
Častěji AI jen odhalí úzká hrdla, která tam byla vždy.
Architektura nebyla nikdy špatná. Byla jen postavena pro jiný typ otázek.
4. Všechno stále běží přes jeden monolitický datový sklad
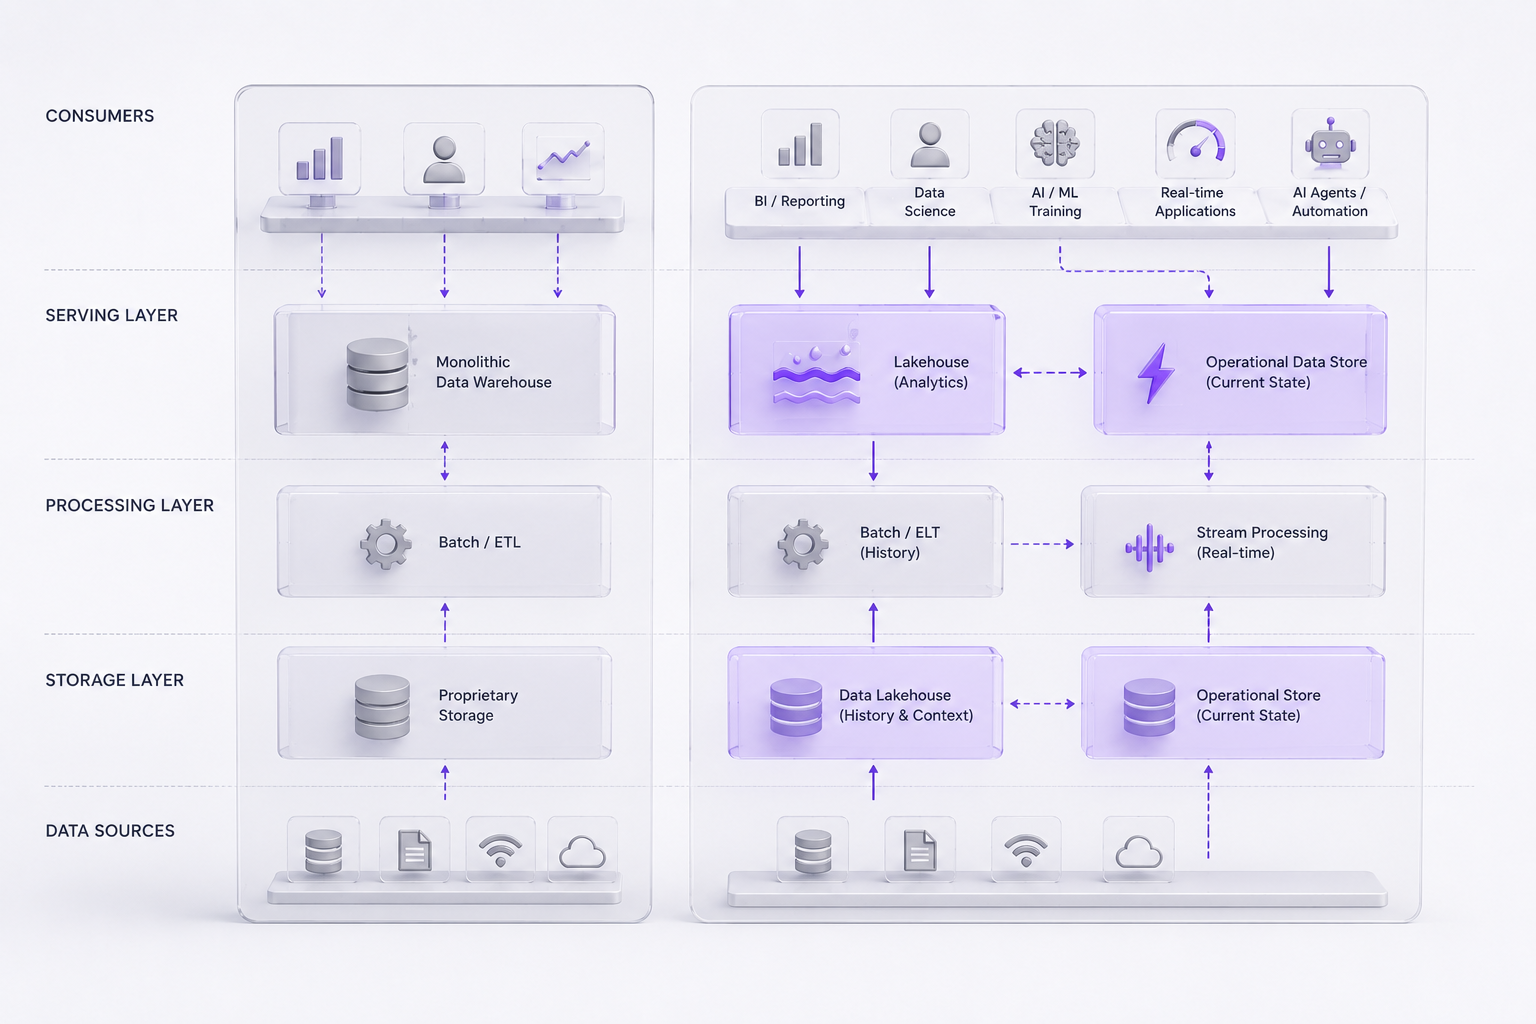
Datový sklad je skvělý pro včerejšek. AI stále častěji potřebuje vědět, co se děje teď.
Klasický warehouse vznikal pro dávkové zpracování, historické agregace a SQL analytiku. Jakmile od něj začnete vyžadovat rychlé provozní dotazy s nízkou latencí, začnou se objevovat jeho limity. Platíte za výkonné úložiště i u dat, která takový výkon nepotřebují, eventová a nestrukturovaná data do něj zapadají obtížně a protože je velká část systému vzájemně propojená, jediná změna může ovlivnit desítky reportů. Všechno běží jednou rychlostí a ta jen málokdy odpovídá tomu, co potřebuje AI.
Řešením není další velká migrace. Je potřeba přijmout, že různé workloady mají různé požadavky. Historická analytika a operativní AI by neměly soupeřit o stejnou architekturu. Data mají svou „teplotu“. Historie, analytika a trénování modelů patří do lakehouse. Aktuální stavová data dávají větší smysl v rychlejší operativní vrstvě, která je pro tento účel navržená. Oddělením těchto dvou světů přestanete škálovat jeden drahý systém kvůli workloadům, které do něj nikdy nepatřily.
5. AI musí mít přístup k vašim klíčovým systémům, aby věděla, co se děje právě teď
Skutečná hodnota AI se často začne ukazovat ve chvíli, kdy dokáže odpovídat na provozní otázky. Vedoucí skladu chce vědět, které objednávky jsou právě teď blokované kvůli chybějícím zásobám. Likvidátor potřebuje zjistit, které případy dnes vyžadují manuální kontrolu. Finance se ptají, zda už byla konkrétní faktura zaplacena.
A právě tehdy řada firem zjistí, že jejich architektura nikdy nebyla navržená tak, aby dokázala bezpečně poskytovat aktuální provozní data. Jedinou možností pak bývá dotazovat se přímo ERP, CRM nebo SAPu. To může být pomalé, drahé a natolik rizikové, že to IT odmítne. A oprávněně.
Právě tady dává smysl operational data store (ODS). ODS funguje jako vrstva mezi core systémy a aplikacemi, které jejich data potřebují. Přes integrační vrstvu do něj proudí pouze relevantní aktuální stav. AI díky tomu dokáže rychle odpovídat na provozní otázky, aniž by zbytečně zatěžovala systémy, na kterých firma stojí. Zároveň vznikne jasná hranice mezi aktuálními provozními daty v ODS a historickými daty v lakehouse.
ODS ale nestavte pro všechno. Začněte třemi až pěti otázkami s nejvyšší obchodní hodnotou.
Co vidíme v praxi
Problém málokdy bývá technický.
Nikdo nikdy nemusel zpřístupnit provozní data mimo hlavní systém, takže neexistuje žádná bezpečná cesta, jak to udělat.
ODS je stejně tak organizační rozhodnutí jako architektonické.
6. „Real-time“ ve skutečnosti neznamená nic konkrétního
Téměř každá velká firma dnes tvrdí, že má real-time data. Když se ale zeptáte, co přesně tím myslí, definice se začne rozpadat. Pro jeden tým jde o kopii dat z core systémů aktualizovanou každých několik minut, pro jiný o hodinovou agregaci streamovaných dat. Další očekává event feed s garantovanou latencí v řádu sekund.
Někdy real-time vrstva existuje hlavně na architektonickém diagramu. Události sice proudí, ale není jasné kudy, nikdo nekontroluje jejich úplnost a nikdo nehlídá, zda skutečně dorazily včas. U AI může být důsledek nenápadný, ale drahý: systém reaguje pozdě a odpověď, která je technicky správná, už v okamžiku doručení nemusí platit.
Začněte proto definicí, ne technologií. Každý use case musí mít jasně stanovené, co pro něj „real-time“ znamená. Pak stačí relativně neatraktivní, ale spolehlivý základ: jasná cesta od zdroje ke konzumentovi, základní validace, monitoring úplnosti a včasnosti dat a člověk, který reaguje, když něco nefunguje. Poznáte, že systém funguje, když zpoždění zachytíte dřív než zákazník.
7. API vzniklo pro jednu aplikaci. A je to na něm vidět.
API je v mnoha firmách historický vedlejší produkt první webové nebo mobilní aplikace, která ho potřebovala. Funguje dobře, dokud se nepokusíte připojit něco dalšího: AI agenta, partnera nebo jiný interní tým. Pak začnou problémy. API je křehké, nemá verzování, každá změna rozbije jiného konzumenta a připojení čehokoli nového se mění v samostatný projekt. Právě tato třecí plocha často odděluje pilot od skutečného škálování.
Změna přístupu je jednoduchá: přestaňte API vnímat jako technické „potrubí“ jedné aplikace a začněte s ním pracovat jako s produktem. Stabilním, verzovaným a řízeným, navrženým kolem konkrétních business capabilities, ne jednotlivých kanálů. Pokud AI dostane stabilní rozhraní k aktuálním a jednoznačně definovaným datům, zmizí velká část workaroundů a ručně slepovaných integrací, na kterých AI projekty často zbytečně ztroskotají.
Co vidíme v praxi
Projekty AI málokdy selžou kvůli chybějícímu API.
Selhávají proto, že každé API bylo postaveno kolem jiné aplikace.
Řešením málokdy bývá více API. Řešením je méně, ale lepších API.
Jakmile AI začne pracovat s dokumenty, disciplína je důležitější než model
Strukturovaná data jsou pouze polovina problému. Velká část nejhodnotnějších AI use cases pracuje s dokumenty: interními směrnicemi, smlouvami, procesy, produktovou dokumentací nebo firemním know-how. A právě zde rozdíl mezi efektním demem a spolehlivým systémem téměř vždy stojí na disciplíně kolem dat.
8. AI odpovídá z vašich dokumentů. Nikdo ale neví z kterých.
Asistent sebevědomě odpoví na otázku týkající se HR směrnice nebo konkrétního ustanovení smlouvy. Odpověď zní správně. Nikdo ale nedokáže říct, z jakého dokumentu ji AI získala, a už vůbec ne, jestli je daný dokument stále platný.
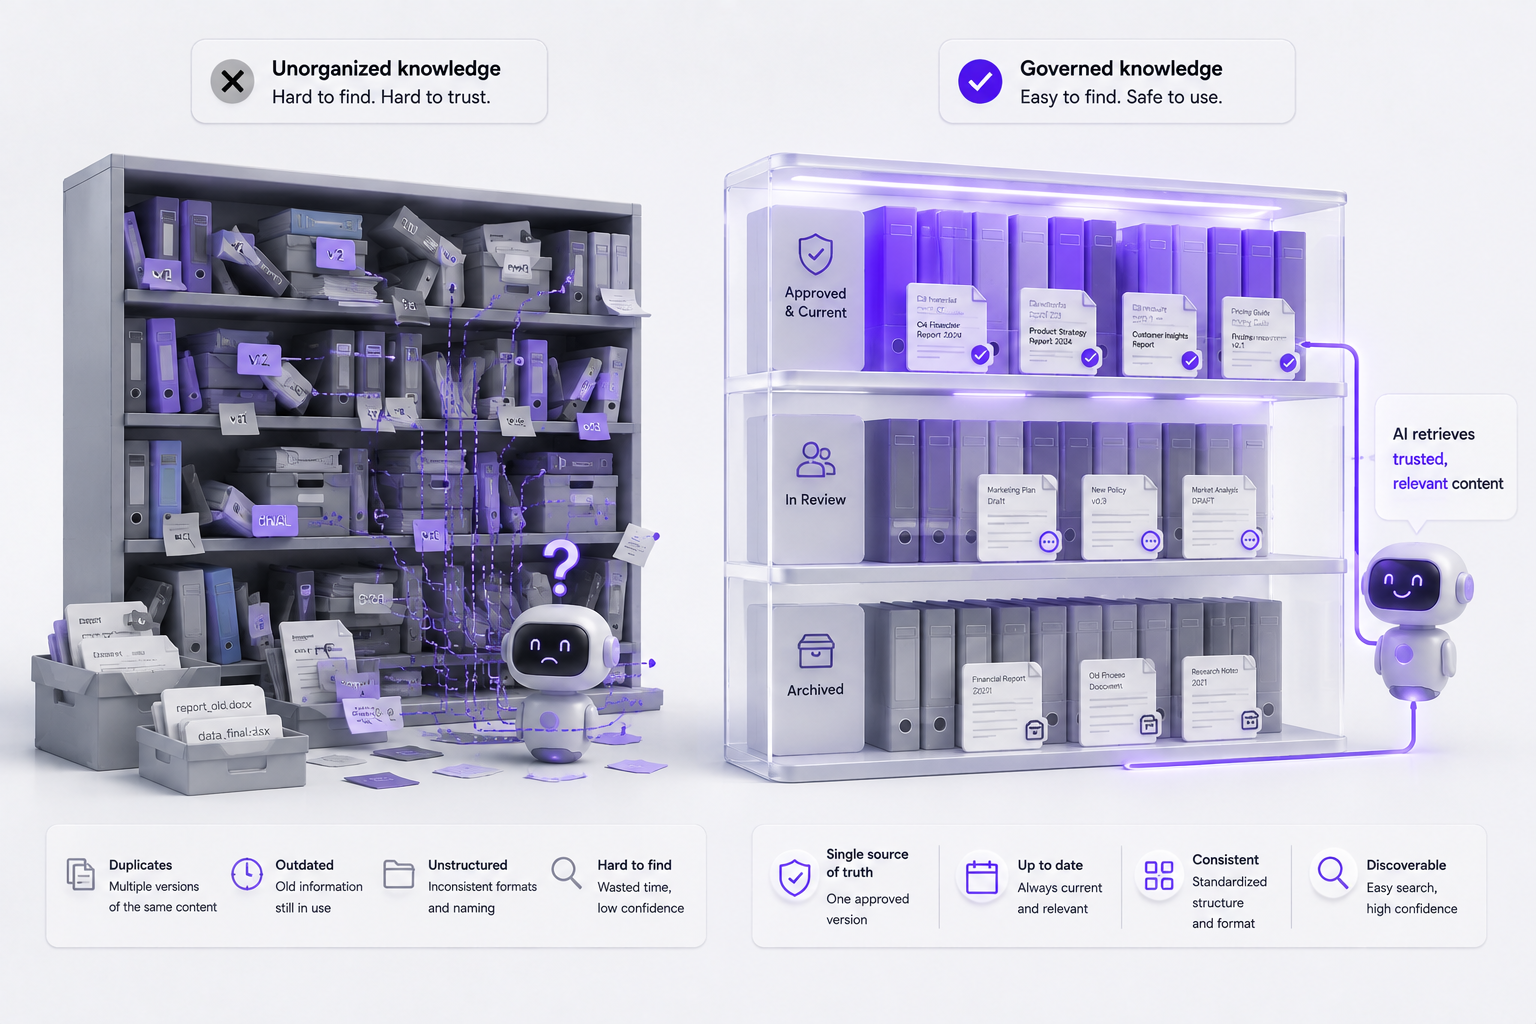
Z našich zkušeností bývá skutečným rizikem málokdy samotný model. Problémem je obsah pod ním: zastaralé soubory, několik verzí stejného dokumentu, chybějící source of truth nebo dokumenty bez jasného vlastníka. AI totiž může vytvořit správnou odpověď ze špatného dokumentu. A v takovém okamžiku důvěra rychle mizí.
Bezpečná AI pracující s firemními znalostmi proto stojí na několika základních principech: používat pouze schválené zdroje, každému zdroji přiřadit vlastníka, respektovat přístupová oprávnění uživatele, pracovat pouze s aktuální verzí a u každé odpovědi uvádět zdroje.
Technicky jde o retrieval-grounded generation. Schválené dokumenty jsou uložené v dokumentovém úložišti s vektorovým indexem, systém vyhledá relevantní pasáže a odpověď vždy propojí s konkrétními podklady. Tím se z odpovědi, která pouze působí věrohodně, stává odpověď, kterou lze obhájit.
Co vidíme v praxi
Nejtěžší částí práce s dokumenty v AI je málokdy samotné vyhledávání.
Je to zjištění, kolik zdrojů pravdy je zastaralých, duplicitních nebo nemá žádného vlastníka.
AI tento problém nevytváří. Jen ho činí nemožným ignorovat.
9. Nikdo ve skutečnosti neví, jestli AI odpovídá a doručuje dobře
Zeptejte se většiny týmů, jak dobře jejich AI funguje, a často dostanete dojem místo měření: „Vypadá to dobře.“ To ale není kontrolní mechanismus.
Právě tak postupně proklouznou problémy: odpověď mimo téma, tvrzení bez zdroje nebo informace, kterou daný uživatel vůbec neměl vidět. A nikdo si toho nevšimne, dokud problém jako první neobjeví zákazník nebo auditor.
Měřit kvalitu přitom není tak složité. Sestavte sadu dvaceti až padesáti skutečných otázek z reálného používání a každou odpověď vyhodnocujte podle tří kritérií: je relevantní, opírá se o konkrétní zdroj a respektuje oprávnění uživatele? Test zopakujte pokaždé, když změníte zdroje nebo proces.
Vedle toho sledujte několik provozních signálů: jak často AI eskaluje požadavek na člověka, jak často odpověď nenajde a kolik odpovědí obsahuje citaci zdroje. Cílem není perfektní skóre. Cílem je mít dostatek důkazů pro rozhodnutí: tohle můžeme škálovat, tohle musíme upravit a tohle bychom měli zastavit.
10. AI patří všem. Takže za ni neodpovídá nikdo.
Poslední signál často rozhoduje o tom, zda se podaří vyřešit i těch předchozích devět. Pokud AI use case nemá vlastníka a každý scénář prochází stejným procesem, firma obvykle skončí v jednom ze dvou extrémů: buď je příliš opatrná na to, aby cokoli nasadila, nebo příliš benevolentní na to, aby AI používala bezpečně.
Stejný asistent může být téměř bez rizika při sumarizaci interního FAQ a zároveň představovat podstatně větší problém ve chvíli, kdy připravuje výstup, podle kterého se rozhoduje zákazník. Přesto firmy často oba případy řídí stejně.
Dobře nastavená AI governance není byrokracie. Je to mechanismus, který umožňuje AI rozšiřovat bez zbytečného strachu. Praktický přístup může být relativně jednoduchý: každý use case musí mít vlastníka, jasně definovanou úroveň rizika a kontrolní mechanismy odpovídající tomuto riziku. Nízkorizikové scénáře mohou běžet automaticky, pokud existuje záznam o jejich činnosti. U rizikovějších případů přidejte lidskou kontrolu, omezené zdroje a jasný eskalační proces.
Pod tím vším stačí pět základů: vlastník, schválené zdroje, přístupová pravidla, auditní stopa a proces pro řešení incidentů. Smyslem není AI zpomalovat. Naopak. Cílem je vytvořit takové podmínky, aby ji firma mohla rozšiřovat s dostatečnou kontrolou a důvěrou.
10 signálů, že vaše data nejsou připraveny na AI (a jak každou z nich vyřešit)
Firmy, které dnes z AI získávají největší hodnotu, nemají nutně lepší modely. Mají lepší datové základy.
Je dobré si přiznat, jak výrazně se samotný model propadl na seznamu věcí, které rozhodují o úspěchu AI projektu. Nejnovější jazykové a embeddingové modely jsou dnes dostupné prakticky všem a působivé demo lze postavit během několika dní.
Demo je jednoduché. Systém za ním už ne. Rozdíl mezi proof of conceptem a řešením, kterému může velká firma skutečně důvěřovat, proto většinou není v modelu. Rozhoduje, jestli se AI může opřít o data, která lze používat opakovaně, bezpečně a konzistentně.
Napříč více než 500 projekty pro více než 100 velkých firem od roku 2016 se opakovaně setkáváme se stejnými varovnými signály. Spadají do tří oblastí: zda lze věřit samotným datům, zda je současná architektura dokáže správně poskytovat a zda AI umí bezpečně pracovat s firemními znalostmi. Tady je deset nejdůležitějších a konkrétní doporučení, jak je řešit.
Nejdřív musíte věřit vlastním číslům
Ještě před architekturou a modely si položte jednodušší otázku: věří lidé ve vaší firmě číslům, se kterými už dnes pracují? Často ne. A AI tento problém velmi rychle odhalí.
1. Stejné KPI znamená pro každý tým něco jiného
Zeptejte se tří oddělení na tržby za minulý měsíc a možná dostanete tři různá čísla. Finance počítají vyfakturované tržby bez DPH, obchod pracuje s uzavřenými objednávkami a dashboard ukazuje ještě třetí hodnotu. Dlouho se s tím dalo žít, protože někdo v místnosti obvykle věděl, které číslo je v daném kontextu správné. AI asistent takový instinkt nemá. Použije definici, ke které dostal přístup. Jakmile vedení firmy dostane od stejného systému dvě protichůdné odpovědi, důvěra v něj mizí velmi rychle.
Řešení je méně technické, než se může zdát. Pro klíčové metriky stanovte jednu společnou definici a jasného vlastníka. Jakoukoli změnu definice řešte jako vědomé a komunikované rozhodnutí, ne jako úpravu, kterou si jeden tým provede sám pro sebe. Společný jazyk pro nejdůležitější KPI umožní AI spory o čísla řešit, ne vytvářet nové.
Co vidíme v praxi
Organizace se často domnívají, že mají problém s kvalitou dat.
Ve skutečnosti mají problém s konzistencí.
Data existují. Firma se prostě neshodne na tom, co znamenají.
2. Data vznikají jako reporty, ne jako datové produkty
V řadě firem data stále vznikají postaru. Někdo položí otázku, analytik vytvoří export, ručně ho vyčistí a pošle dál. Při další otázce celý proces začíná znovu. Samotný report nemusí být chybný. Problém je, že není znovu použitelný. Dva analytici tak mohou na stejnou otázku odpovědět dvěma různými čísly, aniž by bylo jasné, kdo za rozdíl odpovídá.
Přístup data jako produkt tento vztah mění. Kritický dataset už nevzniká pokaždé na objednávku, ale funguje jako dlouhodobě spravovaná služba. Má svého vlastníka, definovanou kvalitu a aktuálnost, jasný význam a plán dalšího rozvoje. Nejde o proces pro proces. Právě díky tomu se může AI zítra spolehnout na stejná data, ze kterých vycházela dnes.
3. Když se něco pokazí v datech, nikdo se to nedozví včas
Datové problémy většinou nepřicházejí s hlasitým alarmem. Feed dorazí pozdě, datová dávka se načte jen částečně nebo se nečekaně změní struktura některého pole. Dashboard přesto dál ukazuje číslo, jako by se nic nestalo.Ve světě reportingu si toho někdo dříve nebo později všimne. Ve světě AI už se mezitím chybná data mohla dostat do odpovědi zákazníkovi. Reporting dokáže pozdní data odpustit. AI ne.
První instinkt bývá monitorovat všechno. To ale většinou vede jen k záplavě alertů, které postupně všichni začnou ignorovat. Začněte datasety, na kterých závisejí vaše první AI use cases, a sledujte tři nejčastější problémy: zda data dorazila včas, zda se jejich objem výrazně neodchýlil od normálu a zda se bez upozornění nezměnila jejich struktura. Každý alert musí mít vlastníka a jednoduchý postup, co dělat dál. Monitorovat všechno vytváří šum. Monitorovat data, na kterých vaše AI skutečně závisí, vytváří důvěru.
I důvěryhodná data mohou narazit na špatnou architekturu
Řada firem si sjednotí definice a zlepší kvalitu dat, ale AI projekty přesto začnou narážet na další bariéru. AI totiž přináší typ workloadu, pro který většina současných datových systémů původně nevznikla. BI vysvětluje, co se stalo. AI stále častěji pomáhá rozhodovat o tom, co se má stát dál, a k tomu potřebuje vědět, co se děje právě teď. Právě tento rozdíl odhaluje limity architektury, které firmy dříve nemusely řešit.
Co vidíme v praxi
Firmy málokdy přestavují svou architekturu jen kvůli AI.
Častěji AI jen odhalí úzká hrdla, která tam byla vždy.
Architektura nebyla nikdy špatná. Byla jen postavena pro jiný typ otázek.
4. Všechno stále běží přes jeden monolitický datový sklad
Datový sklad je skvělý pro včerejšek. AI stále častěji potřebuje vědět, co se děje teď.
Klasický warehouse vznikal pro dávkové zpracování, historické agregace a SQL analytiku. Jakmile od něj začnete vyžadovat rychlé provozní dotazy s nízkou latencí, začnou se objevovat jeho limity. Platíte za výkonné úložiště i u dat, která takový výkon nepotřebují, eventová a nestrukturovaná data do něj zapadají obtížně a protože je velká část systému vzájemně propojená, jediná změna může ovlivnit desítky reportů. Všechno běží jednou rychlostí a ta jen málokdy odpovídá tomu, co potřebuje AI.
Řešením není další velká migrace. Je potřeba přijmout, že různé workloady mají různé požadavky. Historická analytika a operativní AI by neměly soupeřit o stejnou architekturu. Data mají svou „teplotu“. Historie, analytika a trénování modelů patří do lakehouse. Aktuální stavová data dávají větší smysl v rychlejší operativní vrstvě, která je pro tento účel navržená. Oddělením těchto dvou světů přestanete škálovat jeden drahý systém kvůli workloadům, které do něj nikdy nepatřily.
5. AI musí mít přístup k vašim klíčovým systémům, aby věděla, co se děje právě teď
Skutečná hodnota AI se často začne ukazovat ve chvíli, kdy dokáže odpovídat na provozní otázky. Vedoucí skladu chce vědět, které objednávky jsou právě teď blokované kvůli chybějícím zásobám. Likvidátor potřebuje zjistit, které případy dnes vyžadují manuální kontrolu. Finance se ptají, zda už byla konkrétní faktura zaplacena.
A právě tehdy řada firem zjistí, že jejich architektura nikdy nebyla navržená tak, aby dokázala bezpečně poskytovat aktuální provozní data. Jedinou možností pak bývá dotazovat se přímo ERP, CRM nebo SAPu. To může být pomalé, drahé a natolik rizikové, že to IT odmítne. A oprávněně.
Právě tady dává smysl operational data store (ODS). ODS funguje jako vrstva mezi core systémy a aplikacemi, které jejich data potřebují. Přes integrační vrstvu do něj proudí pouze relevantní aktuální stav. AI díky tomu dokáže rychle odpovídat na provozní otázky, aniž by zbytečně zatěžovala systémy, na kterých firma stojí. Zároveň vznikne jasná hranice mezi aktuálními provozními daty v ODS a historickými daty v lakehouse.
ODS ale nestavte pro všechno. Začněte třemi až pěti otázkami s nejvyšší obchodní hodnotou.
Co vidíme v praxi
Problém málokdy bývá technický.
Nikdo nikdy nemusel zpřístupnit provozní data mimo hlavní systém, takže neexistuje žádná bezpečná cesta, jak to udělat.
ODS je stejně tak organizační rozhodnutí jako architektonické.
6. „Real-time“ ve skutečnosti neznamená nic konkrétního
Téměř každá velká firma dnes tvrdí, že má real-time data. Když se ale zeptáte, co přesně tím myslí, definice se začne rozpadat. Pro jeden tým jde o kopii dat z core systémů aktualizovanou každých několik minut, pro jiný o hodinovou agregaci streamovaných dat. Další očekává event feed s garantovanou latencí v řádu sekund.
Někdy real-time vrstva existuje hlavně na architektonickém diagramu. Události sice proudí, ale není jasné kudy, nikdo nekontroluje jejich úplnost a nikdo nehlídá, zda skutečně dorazily včas. U AI může být důsledek nenápadný, ale drahý: systém reaguje pozdě a odpověď, která je technicky správná, už v okamžiku doručení nemusí platit.
Začněte proto definicí, ne technologií. Každý use case musí mít jasně stanovené, co pro něj „real-time“ znamená. Pak stačí relativně neatraktivní, ale spolehlivý základ: jasná cesta od zdroje ke konzumentovi, základní validace, monitoring úplnosti a včasnosti dat a člověk, který reaguje, když něco nefunguje. Poznáte, že systém funguje, když zpoždění zachytíte dřív než zákazník.
7. API vzniklo pro jednu aplikaci. A je to na něm vidět.
API je v mnoha firmách historický vedlejší produkt první webové nebo mobilní aplikace, která ho potřebovala. Funguje dobře, dokud se nepokusíte připojit něco dalšího: AI agenta, partnera nebo jiný interní tým. Pak začnou problémy. API je křehké, nemá verzování, každá změna rozbije jiného konzumenta a připojení čehokoli nového se mění v samostatný projekt. Právě tato třecí plocha často odděluje pilot od skutečného škálování.
Změna přístupu je jednoduchá: přestaňte API vnímat jako technické „potrubí“ jedné aplikace a začněte s ním pracovat jako s produktem. Stabilním, verzovaným a řízeným, navrženým kolem konkrétních business capabilities, ne jednotlivých kanálů. Pokud AI dostane stabilní rozhraní k aktuálním a jednoznačně definovaným datům, zmizí velká část workaroundů a ručně slepovaných integrací, na kterých AI projekty často zbytečně ztroskotají.
Co vidíme v praxi
Projekty AI málokdy selžou kvůli chybějícímu API.
Selhávají proto, že každé API bylo postaveno kolem jiné aplikace.
Řešením málokdy bývá více API. Řešením je méně, ale lepších API.
Jakmile AI začne pracovat s dokumenty, disciplína je důležitější než model
Strukturovaná data jsou pouze polovina problému. Velká část nejhodnotnějších AI use cases pracuje s dokumenty: interními směrnicemi, smlouvami, procesy, produktovou dokumentací nebo firemním know-how. A právě zde rozdíl mezi efektním demem a spolehlivým systémem téměř vždy stojí na disciplíně kolem dat.
8. AI odpovídá z vašich dokumentů. Nikdo ale neví z kterých.
Asistent sebevědomě odpoví na otázku týkající se HR směrnice nebo konkrétního ustanovení smlouvy. Odpověď zní správně. Nikdo ale nedokáže říct, z jakého dokumentu ji AI získala, a už vůbec ne, jestli je daný dokument stále platný.
Z našich zkušeností bývá skutečným rizikem málokdy samotný model. Problémem je obsah pod ním: zastaralé soubory, několik verzí stejného dokumentu, chybějící source of truth nebo dokumenty bez jasného vlastníka. AI totiž může vytvořit správnou odpověď ze špatného dokumentu. A v takovém okamžiku důvěra rychle mizí.
Bezpečná AI pracující s firemními znalostmi proto stojí na několika základních principech: používat pouze schválené zdroje, každému zdroji přiřadit vlastníka, respektovat přístupová oprávnění uživatele, pracovat pouze s aktuální verzí a u každé odpovědi uvádět zdroje.
Technicky jde o retrieval-grounded generation. Schválené dokumenty jsou uložené v dokumentovém úložišti s vektorovým indexem, systém vyhledá relevantní pasáže a odpověď vždy propojí s konkrétními podklady. Tím se z odpovědi, která pouze působí věrohodně, stává odpověď, kterou lze obhájit.
Co vidíme v praxi
Nejtěžší částí práce s dokumenty v AI je málokdy samotné vyhledávání.
Je to zjištění, kolik zdrojů pravdy je zastaralých, duplicitních nebo nemá žádného vlastníka.
AI tento problém nevytváří. Jen ho činí nemožným ignorovat.
9. Nikdo ve skutečnosti neví, jestli AI odpovídá a doručuje dobře
Zeptejte se většiny týmů, jak dobře jejich AI funguje, a často dostanete dojem místo měření: „Vypadá to dobře.“ To ale není kontrolní mechanismus.
Právě tak postupně proklouznou problémy: odpověď mimo téma, tvrzení bez zdroje nebo informace, kterou daný uživatel vůbec neměl vidět. A nikdo si toho nevšimne, dokud problém jako první neobjeví zákazník nebo auditor.
Měřit kvalitu přitom není tak složité. Sestavte sadu dvaceti až padesáti skutečných otázek z reálného používání a každou odpověď vyhodnocujte podle tří kritérií: je relevantní, opírá se o konkrétní zdroj a respektuje oprávnění uživatele? Test zopakujte pokaždé, když změníte zdroje nebo proces.
Vedle toho sledujte několik provozních signálů: jak často AI eskaluje požadavek na člověka, jak často odpověď nenajde a kolik odpovědí obsahuje citaci zdroje. Cílem není perfektní skóre. Cílem je mít dostatek důkazů pro rozhodnutí: tohle můžeme škálovat, tohle musíme upravit a tohle bychom měli zastavit.
10. AI patří všem. Takže za ni neodpovídá nikdo.
Poslední signál často rozhoduje o tom, zda se podaří vyřešit i těch předchozích devět. Pokud AI use case nemá vlastníka a každý scénář prochází stejným procesem, firma obvykle skončí v jednom ze dvou extrémů: buď je příliš opatrná na to, aby cokoli nasadila, nebo příliš benevolentní na to, aby AI používala bezpečně.
Stejný asistent může být téměř bez rizika při sumarizaci interního FAQ a zároveň představovat podstatně větší problém ve chvíli, kdy připravuje výstup, podle kterého se rozhoduje zákazník. Přesto firmy často oba případy řídí stejně.
Dobře nastavená AI governance není byrokracie. Je to mechanismus, který umožňuje AI rozšiřovat bez zbytečného strachu. Praktický přístup může být relativně jednoduchý: každý use case musí mít vlastníka, jasně definovanou úroveň rizika a kontrolní mechanismy odpovídající tomuto riziku. Nízkorizikové scénáře mohou běžet automaticky, pokud existuje záznam o jejich činnosti. U rizikovějších případů přidejte lidskou kontrolu, omezené zdroje a jasný eskalační proces.
Pod tím vším stačí pět základů: vlastník, schválené zdroje, přístupová pravidla, auditní stopa a proces pro řešení incidentů. Smyslem není AI zpomalovat. Naopak. Cílem je vytvořit takové podmínky, aby ji firma mohla rozšiřovat s dostatečnou kontrolou a důvěrou.
Proč AI coding nástroje a nové knihovny nemají běžet přímo na vašem Macu
Když se dnes řeší bezpečnost kolem vibe coding toolů, často to zní, jako by šlo o úplně nový problém. Ve skutečnosti nejde o nic nového. Jen jsme si poslední roky zvykli spouštět cizí kód, cizí dependencies a čím dál častěji i cizí shell commandy přímo na svém lokálním stroji, kde máme SSH klíče, .env soubory, přihlášený browser, přístupy do cloudu a často i produkci.
AI tooling ten problém nevymyslel. Jen ho dost zesílil a udělal viditelnější.
Na macOS je to podle mě vidět asi nejlíp. Spousta lidí nechce vyvíjet v Dockeru, protože DX jde rychle dolů a kontejnery na Macu pořád nejsou bez overheadu. Takže reálný default je pořád stejný: všechno běží na host machine a doufá se, že se nic nestane.
Tohle funguje přesně do chvíle, než to nefunguje.
LiteLLM jen připomněl starý problém
24. března 2026 se na PyPI objevily kompromitované verze litellm 1.82.7 a 1.82.8. Nešlo o žádný exotický exploit. Stačilo udělat pip install a do prostředí se dostal škodlivý .pth soubor, který se spouštěl při startu Pythonu.
Ten pak sahal po věcech, které na vývojářském stroji typicky najde snadno:
- SSH klíče
- .env soubory
- cloud credentials
- další secrets a konfigurační soubory
Pak je odesílal na remote server.
Na tomhle incidentu je důležité hlavně to, jak banální ten attack path byl. Nepotřeboval rozbít Python, obejít kernel ani přesvědčit člověka, aby spustil něco extra. Stačilo, že vývojář udělal to, co dělá běžně každý den: nainstaloval si dependency.
Paradoxně se na celou věc přišlo rychleji i proto, že malware nebyl úplně dobře napsaný a na některých strojích odpálil fork bombu. Kdyby se držel při zemi a jen tiše exfiltroval data, je dost možné, že by to déle unikalo pozornosti.
Podle mě by tomuhle podlehla velká část běžných developerů, ne jen lidi, kteří experimentují s vibe codingem. Důvod je jednoduchý: málokdo má lokální Python prostředí opravdu izolované.
A ani JavaScript svět na tom nebyl líp
Tohle mimochodem není jen Python story.
30. a 31. března 2026 se kompromitoval i axios, jedna z nejpoužívanějších knihoven v JavaScript světě. Útočník převzal maintainer účet na npm a publikoval škodlivé verze axios@1.14.1 a axios@0.30.4.
Zajímavé je, že škodlivý payload nebyl přímo v samotném axiosu. Ty verze jen přidaly novou transitive dependency plain-crypto-js, která se spouštěla přes postinstall hook. Jinými slovy: i tady stačilo udělat obyčejný install a z dependency chainu se stal execution chain.
To je přesně důvod, proč mi přijde nebezpečné tvářit se, že supply-chain riziko je jen problém nějakých pochybných balíčků z okraje ekosystému. Není. Minulý týden se to ukázalo i v jednom z nejběžnějších HTTP clientů pro Node.js.
exclude-newer je rozumný default
Jeden z mála levných guardrailů, které dávají smysl skoro každému, je neinstalovat úplně čerstvé releasy balíčků.
V uv jde použít exclude-newer, takže si dependency resolution omezíte jen na balíčky publikované před zvoleným datem:
[tool.uv]
exclude-newer = "2026-03-24"
Tohle není magická obrana. Jen si tím kupujete čas. Když budete držet třeba 14denní odstup, je slušná šance, že se během té doby na kompromitovaný release přijde a někdo ho stáhne nebo alespoň rozjede warningy napříč komunitou.
Úplně stejná logika platí pro AI coding tools
Stejně jako nechcete bezmyšlenkovitě pouštět čerstvé dependencies na hostu, nechcete na hostu pouštět ani code generátor s plným přístupem ke všemu okolo.
Tohle není argument proti Codexu, Claude Code ani jakémukoliv jinému nástroji. Je to argument proti tomu, jak velký trust těm nástrojům dáváme by default.
Lehké sandboxy jsou dobrý začátek. Codex CLI na macOS historicky používal sandbox-exec a umí tím dost omezit, kam proces smí sáhnout. V Claude Code jde sandbox zapnout přes /sandbox. V obou případech je to výrazně lepší než režim, kde agent vidí celý disk a může bez omezení pouštět shell.
Tohle má dvě praktické výhody:
- agent typicky vidí jen repozitář nebo explicitně povolené cesty
- nemusíte potvrzovat každou drobnost jen proto, abyste měli aspoň nějaký control surface
Pro běžné čtení, editaci souborů a část shell práce je to fakt příjemný middle ground.
Kde tenhle model naráží
Problém je, že lehký sandbox není totéž co skutečná izolace.
Jakmile nástroj potřebuje dělat něco trochu praktičtějšího, začnou vylézat hrany:
- instalace balíčků přes uv, pip, npm nebo podobné nástroje často sahá do globálních cache
- browser tooling nemusí uvnitř sandboxu fungovat dobře nebo vůbec
- některé MCP servery potřebují přístup mimo boundary repa
- dřív nebo později narazíte na command, který prostě musíte pustit mimo sandbox
A v ten moment se stejně vyhodí otázka na vibecodera jestli může systém sandbox odejít a většina klikne prostě na "Yes".
Proto mi přijde důležité neplést si "má nějaký sandbox mode" s "je to bezpečně izolované".
Co podle mě dává smysl víc
Pokud chceme agenty nebo code generátory používat vážně, potřebujeme reálný sandbox. Ideálně separátní VM nebo microVM pro každý projekt. Na Macu to může být něco ve stylu Lima nebo obdobné VM-based řešení. Docker sandboxy jsou v principu podobný směr, i když na macOS často naráží na performance a DX.
Pointa ale není konkrétní produkt. Pointa je trust boundary.
Do takového prostředí přesunete jen to, co ten konkrétní projekt opravdu potřebuje:
- checkout repa
- project-scoped credentials
- lokální cache jen pro ten projekt
- případně browser session nebo MCP servery, ale zase jen tam, kde to dává smysl
Tím snížíte blast radius hned dvakrát.
Za prvé: když agent spustí destruktivní command typu rm -rf /, tak zničí maximálně svůj sandbox.
Za druhé: když nainstalujete kompromitovanou dependency typu infikovaného litellm, tak z ní neodtečou všechny credentials z celého laptopu, ale maximálně to, co jste do toho konkrétního prostředí dali. Ideálně jen dev secrets pro jeden projekt.
To pořád není příjemný incident. Ale je to o řád lepší incident.
Classifier je fajn, ale není to sandbox
Claude Code teď přidal i auto mode, kde nad citlivějšími akcemi běží další classifier. Ten vyhodnocuje transcript a jednotlivé tool calls, hlavně Bash commandy a další akce mimo repo, a snaží se blokovat věci jako data exfiltration, credential hunting nebo destruktivní zásahy mimo scope úkolu.
To je rozumný posun. Approval fatigue je reálná a ruční odklikávání všeho není moc udržitelný model.
Ale i tady je podle mě důležité držet si správné očekávání: classifier je guardrail, ne izolace.
Stejně tak to neřeší supply-chain problém. Pokud si uvnitř důvěryhodného prostředí nainstalujete škodlivý balíček, classifier nad Bash commandy vám nepomůže proti tomu, co ten balíček provede při importu nebo startu interpreteru.
Co bych z toho bral jako praktický default
Můj aktuální take je jednoduchý:
- nepouštět úplně čerstvé dependencies bez odstupu
- neprovozovat AI coding tools přímo na host machine s plným přístupem
- když už používám lehký sandbox, nebrat ho jako finální řešení
- pro důležitější práci mít per-project izolované prostředí s omezeným blast radiusem
Tohle všechno platilo už dávno předtím, než někdo vymyslel termín vibe coding.
Jen teď už není moc kam uhýbat. Když dáte agentovi shell, filesystem, browser a credentials, dáváte mu v praxi velmi silné pravomoci. A jak ukázal LiteLLM incident, podobně silné pravomoci dostává i obyčejný package manager ve chvíli, kdy mu bez izolace dovolíte instalovat cizí kód přímo na svůj laptop.
To není niche security debata. To je docela obyčejný engineering default, který jsme měli mít už dávno.
Apple právě pracuje na novém container enginu který tohle všechno bude mít doufám built in. Do té doby se snažím opravdu koukat kdykoliv se spouští příkazy mimo sandbox.
UCP, ACP, MCP v agentic commerce: AI už jen nedoporučuje, ale opravdu nakupuje
Současná situace
Za posledních pár měsíců se v oblasti AI a e-commerce objevilo několik zásadních novinek:
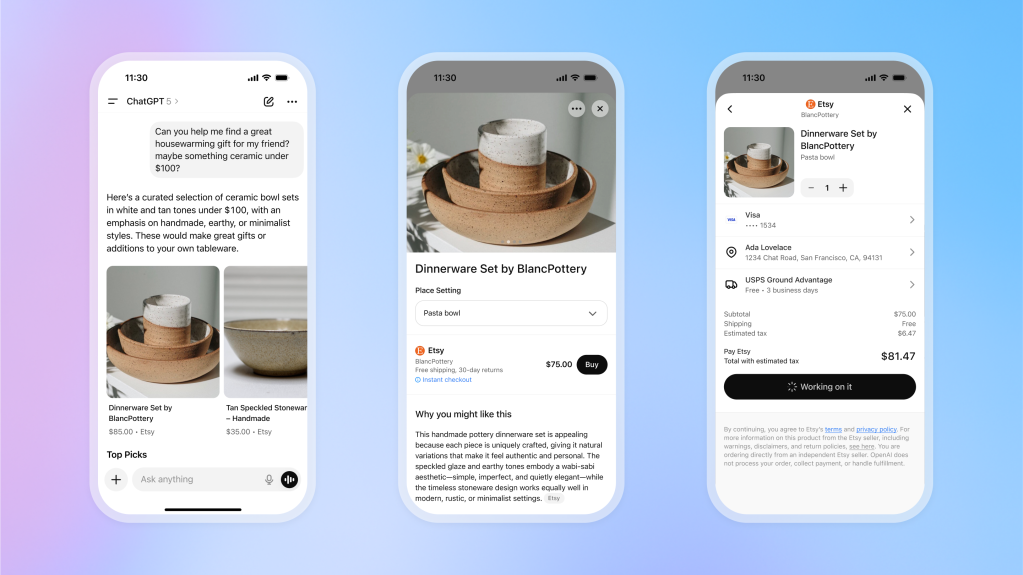
- Google představil UCP (Universal Commerce Protocol) – otevřený standard pro „agentic commerce“, který sjednocuje, jak AI agent mluví s merchantem: katalog, košík, doprava, platba, objednávka.
- OpenAI a Stripe dříve uvedli ACP (Agentic Commerce Protocol) – standard pro agentní checkout v ekosystému ChatGPT.
- Současně se rozšířil MCP (Model Context Protocol) jako obecný standard pro volání nástrojů a služeb a OpenAI Apps SDK jako produktová/distribuční vrstva pro agentní aplikace.
Jinými slovy: internet si začíná definovat standardizované „koleje“, po kterých budou AI agenti nakupovat. A trh se posouvá od režimu „AI něco doporučí“ k režimu „AI nákup skutečně provede“.
V článku probereme:
- co znamená agentic commerce v praxi,
- jak spolu souvisí UCP, MCP, Apps SDK a ACP,
- co tyto protokoly řeší – a co naopak neřeší,
- a kde dává smysl custom agentic commerce – přesně typ práce, které se věnujeme v BigHub.
Co je agentic commerce
Agentic commerce je forma digitálního obchodování, kdy autonomní AI agent obslouží část nebo celý nákupní proces za člověka či firmu – od hledání přes porovnávání až po zaplacení.
Typický scénář:
„Najdi mi běžecké boty na maraton do 3 000 Kč, které mi stihnou přijít do dvou týdnů.“
Agent poté:
- pochopí zadání,
- projde nabídky více obchodníků,
- porovná parametry, recenze, cenu a dopravu,
- připraví shortlist,
- po schválení uživatelem nákup dokončí – ideálně bez toho, aby člověk musel řešit klasický webový košík.
Podobné scénáře se netýkají jen B2C. Stejný princip lze použít pro:
- interní nákup materiálu,
- B2B objednávky,
- opakované doplňování zásob,
- servisní a reklamační procesy.
Směr je jasný: AI se posouvá z roviny „pomoz mi vybrat“ do roviny „postarej se o to“.
MCP, Apps SDK, UCP, ACP
MCP – obecný standard pro nástroje a capabilities
MCP (Model Context Protocol) je:
- obecný standard pro to, jak agent volá nástroje, API a služby,
- doménově neutrální vrstva („umím mluvit s CRM, pricingem, katalogem, ERP…“),
- způsob, jak agent „vidí“ svět skrz capabilities, které má k dispozici.
Zjednodušeně: MCP = jak agent sahá do vašich systémů.
OpenAI Apps SDK – produktová a distribuční vrstva
OpenAI Apps SDK:
- řeší UI, runtime a distribuci agentů (ChatGPT Apps, rozhraní pro uživatele),
- umožňuje rychle zabalit agenta do produktu:
- chat, formuláře, akce,
- publikace do ekosystému ChatGPT,
- základní správu a běh.
Zjednodušeně: Apps SDK = jak z agenta udělat reálně používaný produkt.
UCP – doménový standard pro commerce workflow
UCP (Universal Commerce Protocol) od Google a partnerů:
- je doménový standard pro commerce,
- sjednocuje, jak agent mluví s merchantem o:
- katalogu, variantách a cenách,
- košíku, dopravě, platbě, objednávce,
- slevách, věrnostních programech, refundech a trackingu,
- je navržený tak, aby fungoval napříč Google Search, Gemini a dalšími AI surfaces.
Zjednodušeně: UCP = konkrétní jazyk a workflow nákupu.
ACP – standard pro agentní checkout v ChatGPT
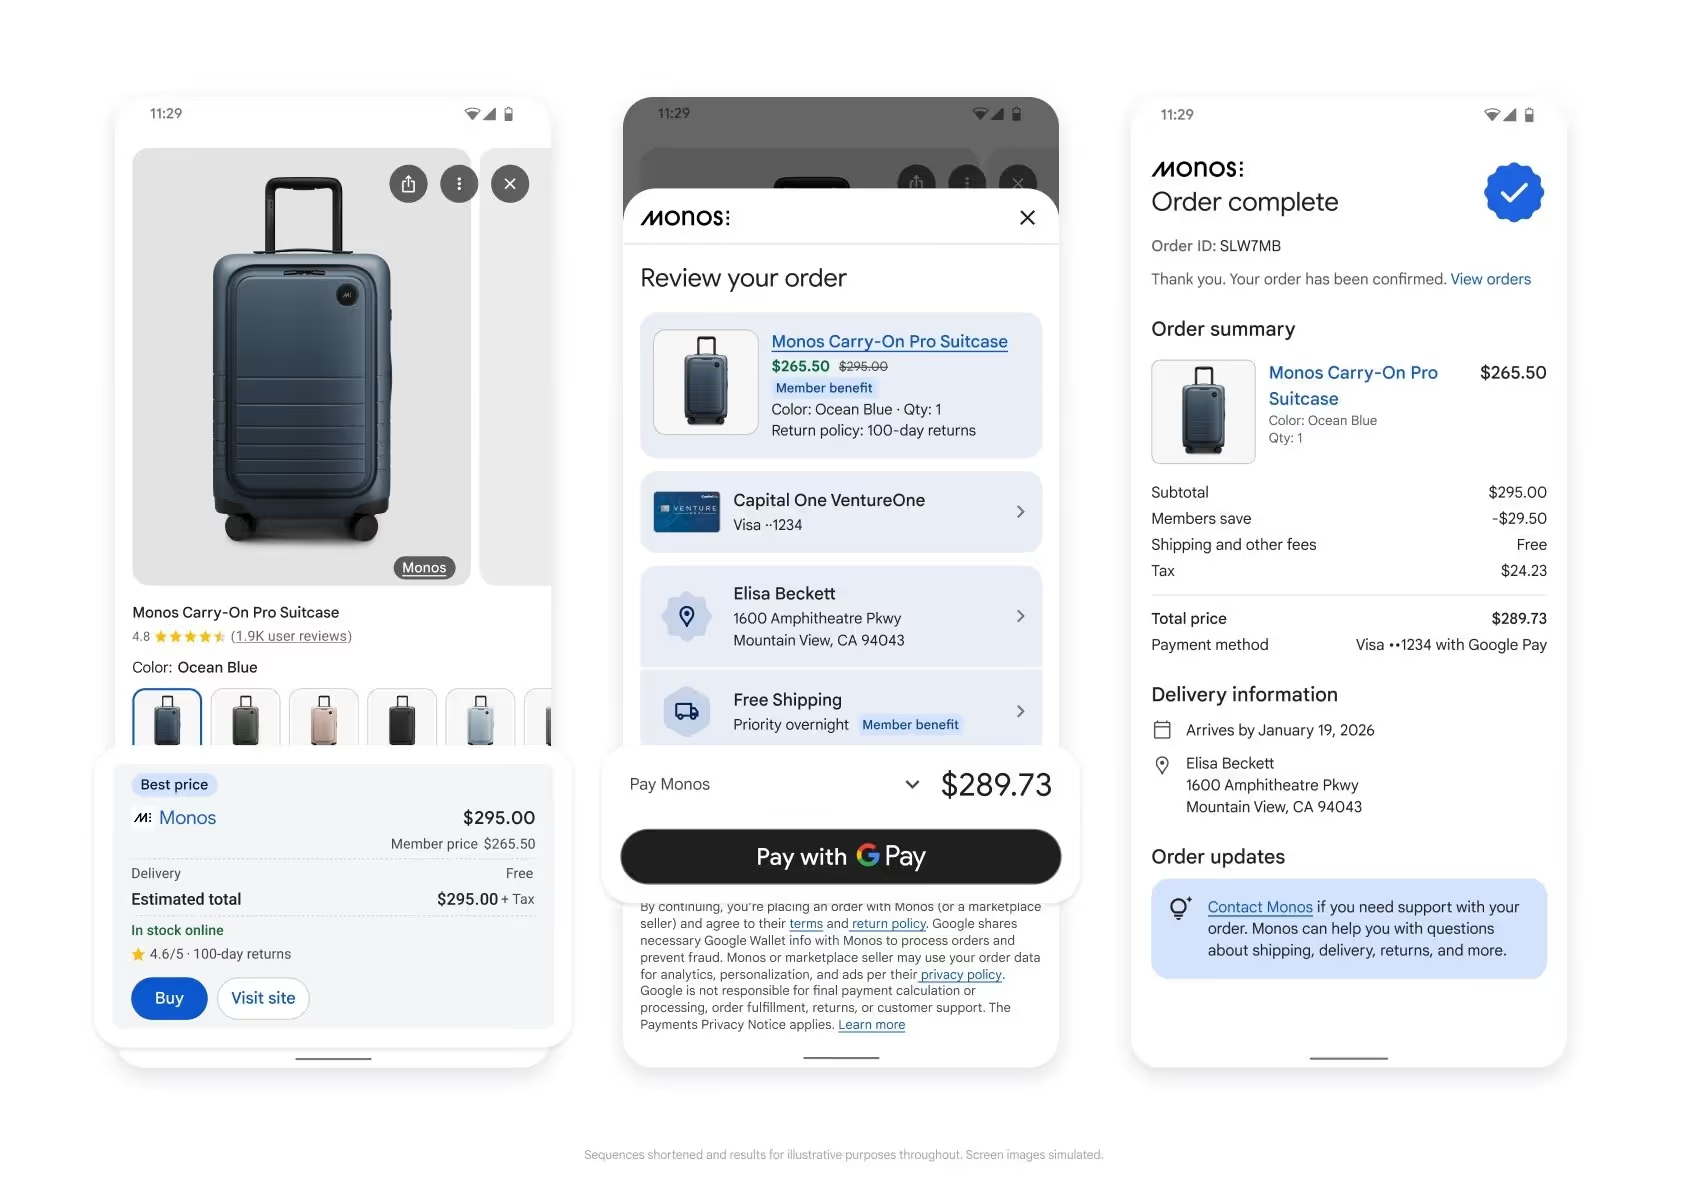
ACP (Agentic Commerce Protocol) od OpenAI/Stripe:
- řeší podobnou doménu z pohledu ChatGPT ekosystému,
- soustředí se silně na checkout, platby a objednávku,
- stojí za funkcemi typu Instant Checkout v ChatGPT.
Z pohledu obchodníka jsou UCP a ACP konkurenční commerce standardy (nikdo nechce tři různé integrace).
Z pohledu architektury jde ale o možné „dialekty“, které může agent používat podle kanálu, odkud přichází (ChatGPT vs. Google / Gemini).
Co tyto standardy řeší – a co ne
Společné je jedno - UCP ani ACP z agenta neudělají „mozek“. Jen mu dají jednotný jazyk.
Standardy typicky řeší:
- jak agent formálně komunikuje s merchantem a checkoutem,
- jak strukturovaně vypadají nabídky a objednávky,
- jak bezpečně probíhá platba a autorizace,
- jak se dá nákup zpracovat napříč různými AI kanály.
Neřeší (a ani nemůžou řešit):
- kvalitu a strukturu produktového katalogu, atributů a dostupnosti,
- integraci do ERP, WMS/OMS, CRM, věrnostního systému, pricing enginu, kampaní,
- business logiku – marže vs. SLA vs. zákaznická zkušenost vs. obrat,
- governance, risk, schvalování – kdo má právo co objednat, kdy musí zasáhnout člověk, jak se auditují rozhodnutí.
Prakticky to znamená:
- můžete být formálně „UCP/ACP ready“,
- ale agentická zkušenost bude pořád špatná, pokud:
- data jsou nekonzistentní,
- doručovací sliby se nedají splnit,
- pricing a promo logika nedrží v multi-channel světě pohromadě,
- agent nemá přístup k reálným stavům a interním pravidlům.
Standard je nutné technické minimum, ne hotové řešení.
Jak k agentic commerce přistupujeme v BigHub
V BigHub vnímáme UCP, MCP, ACP a Apps SDK jako stavební bloky infrastruktury. Na projektech se soustředíme na to, co nad nimi vytvoří skutečnou konkurenční výhodu.
Stavíme ML-powered commerce agenty, kteří umí:
- dynamické nabídky a cenotvorbu (bundly, alternativy, chytré trade-offy podle marže, SLA a priorit),
- personalizované vyhledávání a shortlist (kontext zákazníka, preference, rozpočet, historie interakcí),
- argumentaci a práci s námitkami (proč právě tahle varianta, srovnání možností, vysvětlení trade-offů),
- a v neposlední řadě hladký checkout, přes platbu a finální nákup.
Nad tím stavíme integrační vrstvu přes MCP (capabilities + napojení na core systémy). Jako UI a distribuční vrstvu často používáme OpenAI Apps SDK, když potřebujeme rychle dostat agenta k reálným uživatelům. Tam, kde to dává smysl, využíváme standardy jako UCP/ACP, místo abychom psali proprietární integrace pro každý kanál zvlášť.
Kde dává smysl custom agentic commerce
Standardy (UCP/ACP/MCP) mají velkou hodnotu tam, kde:
- nechcete vymýšlet vlastní protokol pro napojení na AI kanály,
- potřebujete interoperabilitu (ChatGPT, Google/Gemini, další),
- chcete snížit integrační zátěž na straně merchantů.
Custom přístup dává největší smysl v těchto oblastech:
1) Propojení agenta s core systémy
- ERP, WMS/OMS, CRM, věrnostní programy, pricing engine, reklamace, call centrum…
- agent musí žít v reálné provozní architektuře, ne v izolovaném sandboxu.
Typicky je potřeba vlastní integrační a orchestrace vrstva, která:
- „nahoru“ mluví UCP/ACP/MCP,
- „dolů“ mluví vašimi konkrétními systémy a API.
2) Doménová logika a business pravidla
Tady vzniká skutečná konkurenční výhoda:
- kdy může agent objednat autonomně a kdy má jen doporučovat,
- jak balancuje marži, SLA, dostupnost, zákaznickou zkušenost a obrat,
- jak zachází s akcemi, věrnostními body, cross-sell / up-sell scénáři.
Tohle už není otázka protokolu, ale konkrétních pravidel nad daty a KPI vaší firmy.
3) Multi-kanál a mix B2C / B2B / interních agentů
Reálný svět vypadá takto:
- B2C e-shop,
- B2B portál,
- interní agent pro nákup,
- prodejní asistent na prodejně,
- agent v zákaznické péči.
Custom framework umožní:
- sdílet logiku napříč rolemi a kanály,
- pracovat s oprávněními a limity,
- řešit scénáře typu „AI začne v chatu, dokončí na pobočce“.
4) Evropský kontext: regulace, bezpečnost, data residency
U evropských firem hraje velkou roli:
- regulace (EU AI Act, GDPR, sektorová regulace),
- bezpečnostní politika, interní audity,
- kde běží data a modely (US vs. EU),
- jak vysvětlitelná a auditovatelná jsou rozhodnutí agenta.
Standardy jsou globální, ale architektura a governance musí být lokální a na míru.
Co si z UCP a spol. odnést jako retailer / enterprise
Pokud přemýšlíte o agentic commerce, stojí za to položit si několik praktických otázek:
- Jsme „agent-ready“ nejen na úrovni protokolu, ale i dat a procesů?
- Ve kterých use-casech chceme, aby agent nákup opravdu provedl, a kde má zůstat jen u doporučení?
- Jak agentic commerce zapadne do našich stávajících systémů, pricingu, kampaní a SLA?
- Kdo u nás vlastní agentní iniciativy (KPI, P&L) a jak je budeme měřit?
- Které části dává smysl řešit přes standardy (UCP/ACP/MCP) a kde už potřebujeme vlastní agentní framework?
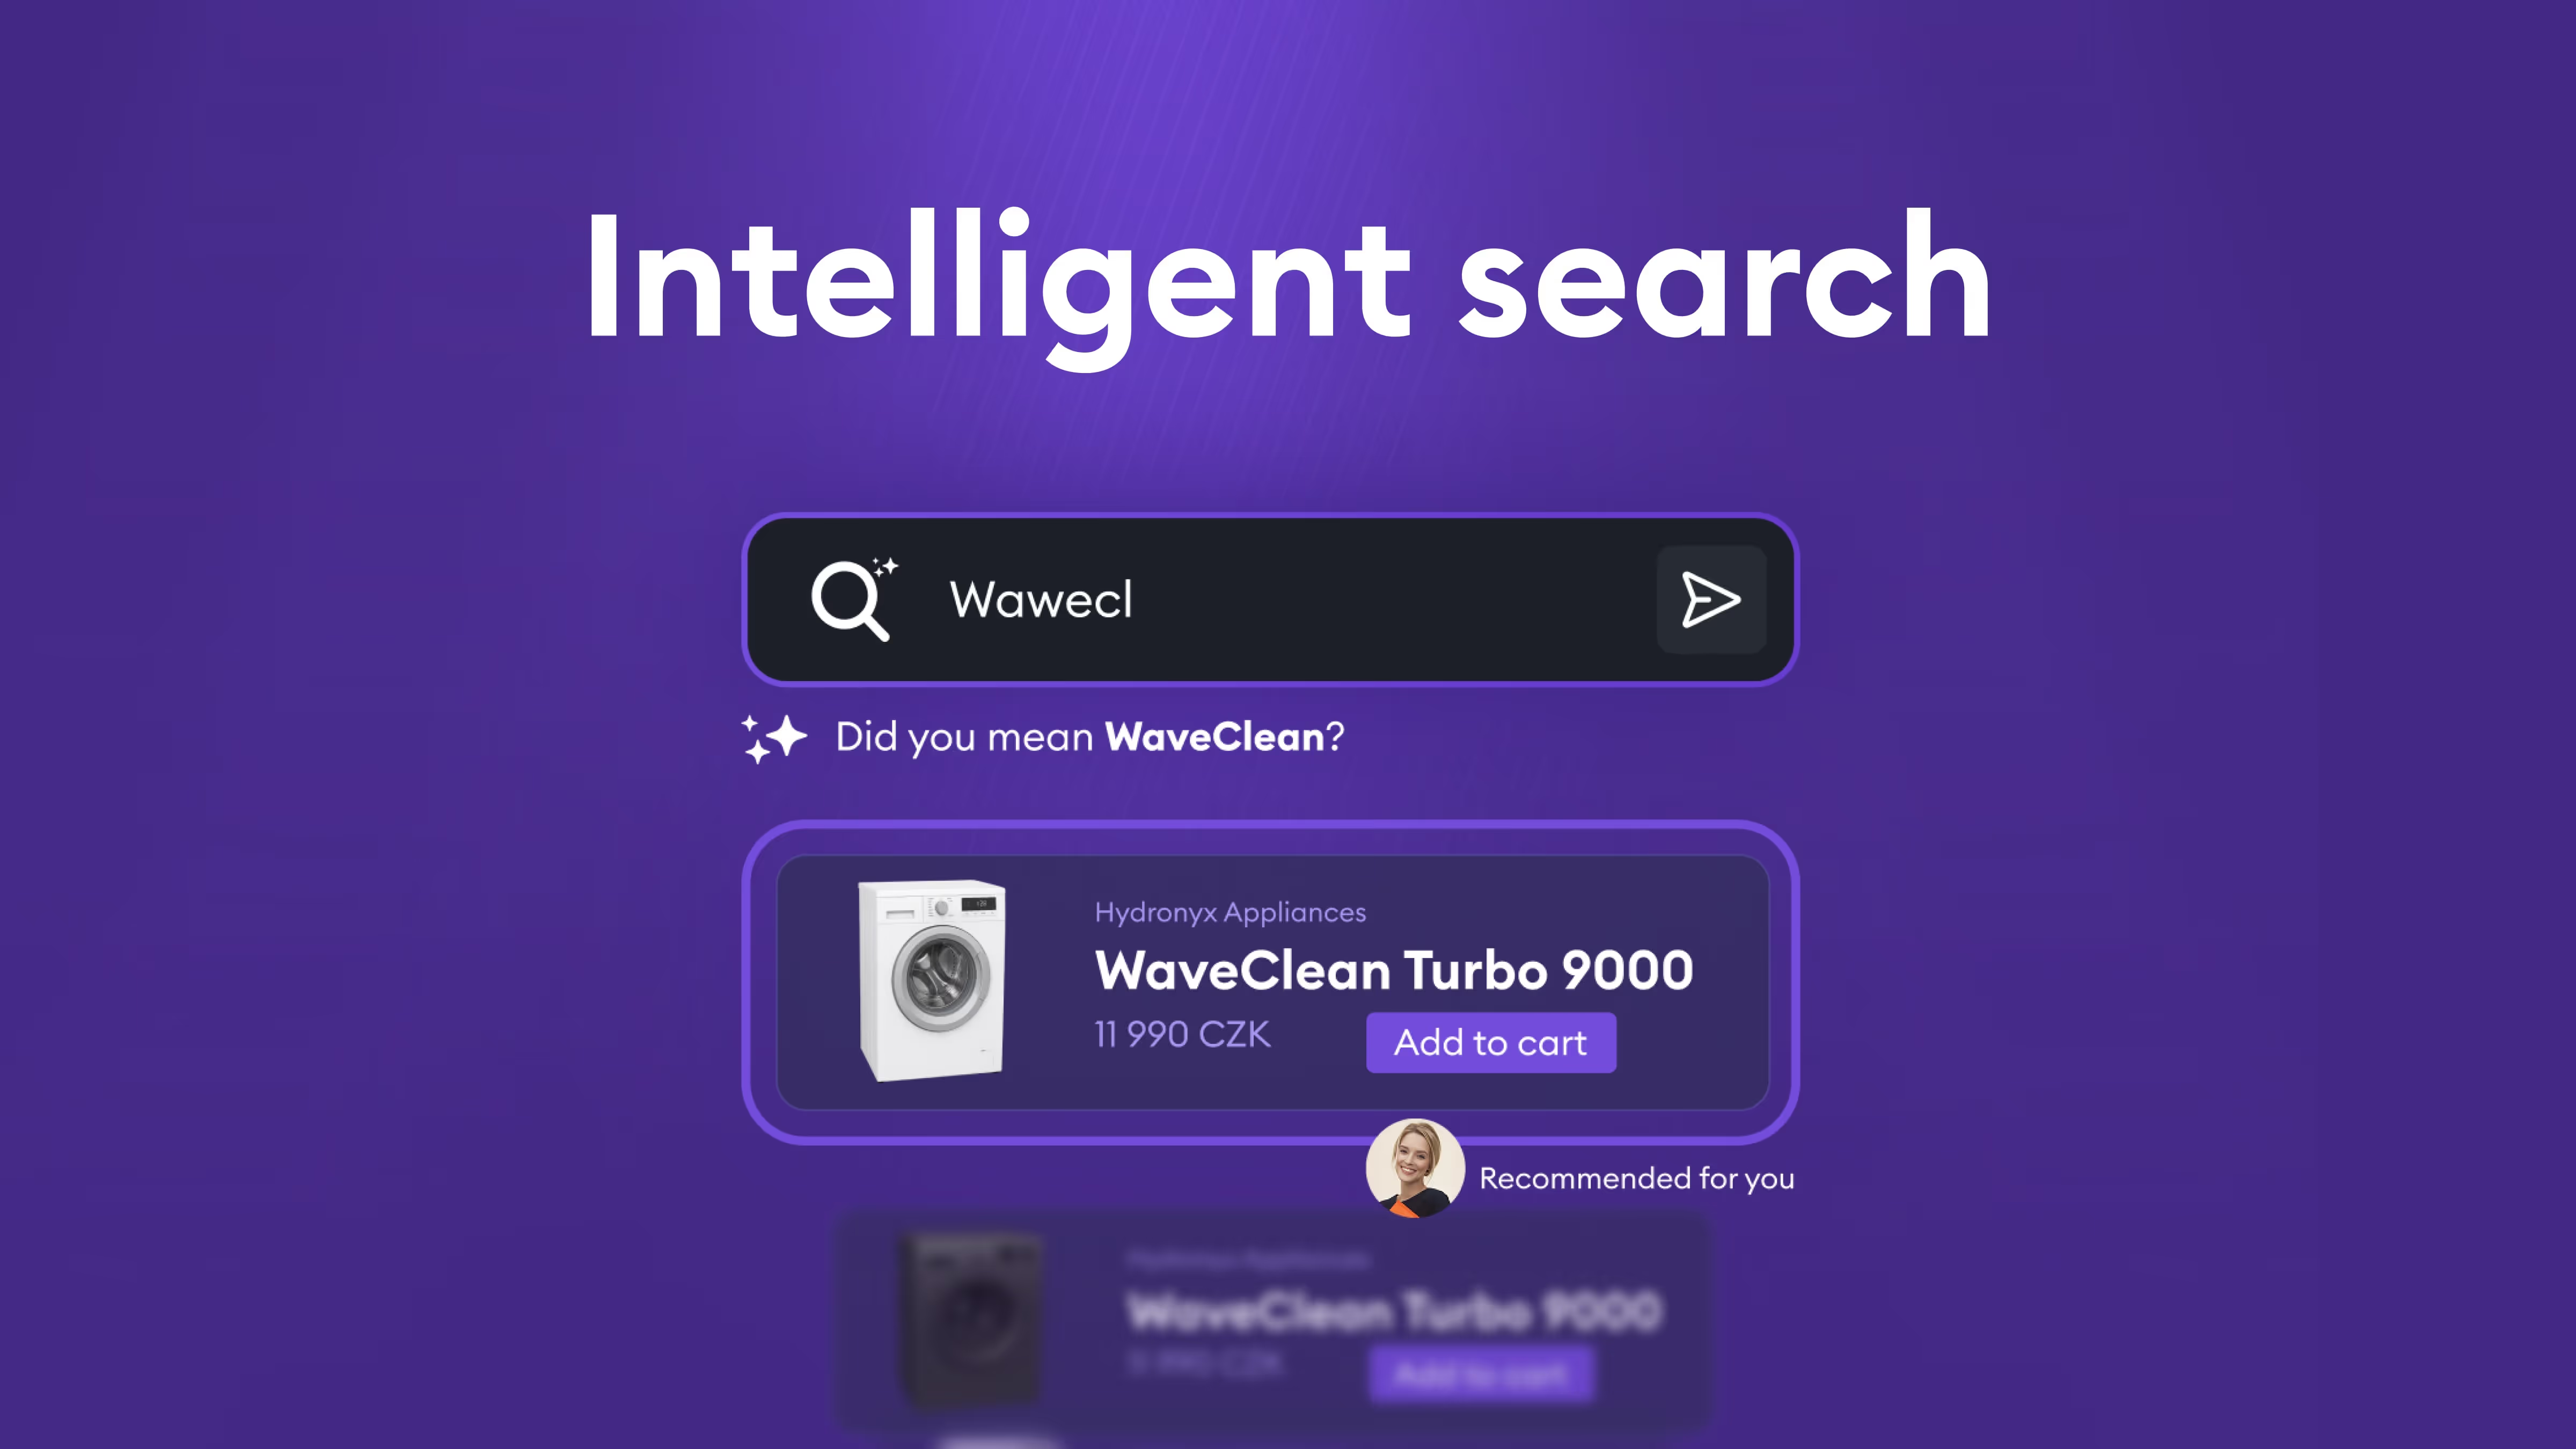
Jak vytvořit inteligentní vyhledávání: Od fulltextu k hybridnímu vyhledávání s optimalizací
Problém: Limity tradičního vyhledávání
Tradiční fulltextové vyhledávání, založené na algoritmech jako BM25, má několik zásadních omezení:
1. Překlepy a variace
- Uživatelé často píší dotazy s překlepy nebo používají různé varianty názvů
- Tradiční vyhledávání vyžaduje přesnou shodu nebo velmi podobný text
2. Vyhledávání pouze v názvech
- Fulltextové vyhledávání typicky hledá pouze v konkrétních polích (například název produktu nebo entity)
- Pokud je relevantní informace v popisu nebo v souvisejících entitách, systém ji nenajde
3. Chybějící sémantické porozumění
- Systém nerozpozná synonyma nebo související koncepty
- Například dotaz "auto" nenajde výsledky obsahující "automobil" nebo "vůz", i když jde o stejný koncept
- Mezijazyčné vyhledávání je téměř nemožné – český dotaz nenajde anglické výsledky
4. Kontextové vyhledávání
- Uživatelé často hledají podle kontextu, ne přesných názvů
- Například dotaz "produkty od výrobce X" by měl najít všechny relevantní produkty, i když název výrobce není explicitně uveden v dotazu
Řešení: Hybridní vyhledávání s embeddingy
Řešením je kombinace dvou přístupů: tradičního fulltextového vyhledávání (BM25) a vektorových embeddingů pro sémantické vyhledávání.
Vektorové embeddingy pro sémantické porozumění
Vektorové embeddingy převádějí text do vícerozměrného prostoru, kde podobné významy jsou blízko sebe. To umožňuje:
- Vyhledávání podle významu: Dotaz "notebook" najde výsledky obsahující "laptop", "přenosný počítač" nebo dokonce související koncepty
- Mezijazyčné vyhledávání: Český dotaz může najít anglické výsledky, pokud mají podobný význam
- Kontextové vyhledávání: Systém rozumí vztahům mezi entitami a koncepty
- Vyhledávání v celém obsahu: Embeddingy mohou být vytvořeny z celého dokumentu, nejen z názvu
Proč embeddingy samotné nestačí
I když jsou embeddingy mocným nástrojem, samy o sobě nejsou dostatečné:
- Překlepy: Vektorové embeddingy mohou mít problém s překlepy, protože malá změna v textu může vést k odlišnému embeddingu
- Přesné shody: Někdy chceme najít přesnou shodu názvu, což fulltextové vyhledávání dělá lépe
- Výkon: Vektorové vyhledávání může být pomalejší než optimalizované fulltextové indexy
Hybridní přístup: BM25 + HNSW
Ideální řešení kombinuje oba přístupy:
- BM25 (Best Matching 25): Tradiční fulltextový algoritmus, který exceluje v přesných shodách a zpracování překlepů
- HNSW (Hierarchical Navigable Small World): Efektivní algoritmus pro vyhledávání v prostoru vektorů, který umožňuje rychlé nalezení nejbližších sousedů v embedding prostoru
Kombinací těchto dvou přístupů získáme to nejlepší z obou světů: přesnost fulltextového vyhledávání pro přesné shody a sémantické porozumění embeddingů pro kontextové dotazy.
Výzva: Správné seřazení výsledků
Najít relevantní výsledky je jen první krok. Stejně důležité je je správně seřadit. Uživatelé typicky klikají na první několik výsledků, takže špatné seřazení může výrazně snížit užitečnost vyhledávání.
Proč samotné seřazení (sort by) nestačí
Jednoduché seřazení podle jednoho kritéria (například data) není dostatečné, protože potřebujeme zohlednit více faktorů současně:
- Relevance: Jak dobře výsledek odpovídá dotazu (z fulltextového i vektorového vyhledávání)
- Obchodní hodnota: Výsledky s vyšší marží by měly být výše
- Čerstvost: Novější položky jsou často relevantnější než staré
- Popularita: Populárnější položky mohou být pro uživatele zajímavější
Scoring funkce: Kombinace více faktorů
Místo jednoduchého "sort by" potřebujeme komplexní scoring systém, který kombinuje:
- Fulltextové skóre: Jak dobře výsledek odpovídá dotazu podle BM25
- Vektorové distance: Sémantická podobnost podle embeddingů
- Scoring funkce:
- Magnitude funkce pro marži/popularitu (vyšší hodnoty = vyšší skóre)
- Freshness funkce pro čas (novější = vyšší skóre)
- Další obchodní metriky podle potřeby
Výsledné skóre je pak vážená kombinace všech těchto faktorů. Problém je, že správné váhy nejsou zřejmé a musíme je najít experimentálně.
Hyperparameter search: Hledání optimálních vah
Správné nastavení vah pro fulltextové vyhledávání, vektorové embeddingy a scoring funkce je kritické pro kvalitu výsledků. Tento proces se nazývá hyperparameter search.
Vytvoření testovacího datasetu
Základem úspěšného hyperparameter search je kvalitní testovací dataset. Vytvoříme dataset dotazů, u kterých přesně víme, jak by měly vypadat ideální výsledky:
- Referenční výsledky: Pro každý testovací dotaz máme seznam očekávaných výsledků v správném pořadí
- Anotace: Každý výsledek je označen jako relevantní nebo nerelevantní, případně s prioritou
- Reprezentativní vzorky: Dataset by měl pokrývat různé typy dotazů (přesné shody, synonyma, překlepy, kontextové dotazy)
Metriky pro hodnocení kvality
Abychom mohli objektivně posoudit, zda jsou výsledky dobré, potřebujeme metriky, které porovnávají skutečné výsledky s referenčními:
1. Kontrola úplnosti (Recall)
- Obsahují výsledky vše, co by měly obsahovat?
- Jsou všechny relevantní položky přítomny v seznamu výsledků?
2. Kontrola pořadí (Ranking Quality)
- Jsou výsledky ve správném pořadí?
- Jsou nejrelevantnější výsledky na prvních místech?
Mezi konkrétní metriky patří například NDCG (Normalized Discounted Cumulative Gain), která hodnotí jak úplnost, tak správné pořadí výsledků. Další užitečné metriky zahrnují Precision@K (kolik relevantních výsledků je v prvních K pozicích) nebo MRR (Mean Reciprocal Rank), která měří pozici prvního relevantního výsledku.
Iterativní optimalizace
Proces hyperparameter search probíhá iterativně:
- Nastavení počátečních vah: Začneme s rozumnými výchozími hodnotami
- Testování kombinací: Systematicky testujeme různé kombinace vah pro:
- Váhy fulltextových polí (například název produktu vs. popis)
- Váhy vektorových polí (embeddingy pro různé části dokumentu)
- Boost hodnoty pro scoring funkce (marže, čas, popularita)
- Agregační funkce (jak kombinovat různé scoring funkce)
- Hodnocení výsledků: Pro každou kombinaci spustíme vyhledávání na testovacím datasetu a vypočítáme metriky
- Výběr nejlepších parametrů: Vybereme kombinaci s nejlepšími metrikami
- Refinování: Pokud je to potřeba, zúžíme rozsah testování kolem nejlepších hodnot a opakujeme proces
Tento proces může být časově náročný, ale je nezbytný pro dosažení optimálních výsledků. Automatizace tohoto procesu umožňuje testovat stovky nebo tisíce kombinací parametrů a najít ty nejlepší.
Sledování a iterativní zlepšování
I po optimalizaci parametrů je důležité systém kontinuálně sledovat a zlepšovat.
Sledování chování uživatelů
Klíčovou metrikou je, zda uživatelé klikají na výsledky, které jim systém nabízí. Pokud uživatel neklikne na první výsledek, ale až na třetí nebo čtvrtý, je to signál, že seřazení není optimální.
Co sledovat:
- Click-through rate (CTR): Kolik uživatelů klikne na výsledky
- Pozice kliknutí: Na které pozici uživatelé klikají (ideálně by měli klikat na první výsledky)
- Dotazy bez kliknutí: Dotazy, na které uživatelé vůbec nekliknou, mohou indikovat špatné výsledky
Analýza problémových případů
Když identifikujeme dotazy, kde uživatelé neklikají na první výsledky, měli bychom:
- Zaznamenat tyto případy: Uložit dotaz, vrácené výsledky a pozici, na kterou uživatel klikl
- Analyzovat: Proč systém vrátil špatné pořadí? Chybí relevantní výsledky? Jsou na špatných pozicích?
- Přidat do testovacího datasetu: Tyto případy by měly být součástí našeho testovacího datasetu pro budoucí optimalizace
- Upravit váhy: Na základě analýzy můžeme upravit váhy nebo přidat nová pravidla
Tento iterativní proces zajišťuje, že systém se neustále zlepšuje a přizpůsobuje se skutečnému chování uživatelů.
Implementace na Azure: AI Search a OpenAI Embeddings
Všechny tyto komponenty můžeme efektivně implementovat pomocí služeb Microsoft Azure.
Azure AI Search
Azure AI Search (dříve Azure Cognitive Search) poskytuje:
- Hybridní vyhledávání: Nativní podpora pro kombinaci fulltextového (BM25) a vektorového vyhledávání
- HNSW indexy: Efektivní implementace HNSW algoritmu pro vektorové vyhledávání
- Scoring profiles: Flexibilní systém pro definování vlastních scoring funkcí
- Text weights: Možnost nastavit váhy pro různá fulltextová pole
- Vector weights: Možnost nastavit váhy pro různá vektorová pole
Azure AI Search umožňuje definovat scoring profiles, které kombinují:
- Magnitude scoring funkce pro numerické hodnoty (marže, popularita)
- Freshness scoring funkce pro časové hodnoty (datum vytvoření, datum aktualizace)
- Text weights pro fulltextová pole
- Vector weights pro vektorová pole
- Agregační funkce pro kombinování různých scoring funkcí
OpenAI Embeddings
Pro vytváření embeddingů používáme OpenAI Embeddings, konkrétně modely jako text-embedding-3-large:
- Kvalitní embeddingy: OpenAI modely poskytují vysoce kvalitní embeddingy, které dobře fungují i pro češtinu
- Konzistentní API: Jednoduchá integrace s Azure AI Search
- Škálovatelnost: OpenAI API zvládne velké objemy požadavků
OpenAI embeddingy jsou zvlášť vhodné pro češtinu, protože byly trénovány na vícejazyčných datech a poskytují dobré výsledky i pro menší jazyky.
Integrace
Azure AI Search umožňuje přímo použít OpenAI embeddingy jako vectorizer, což zjednodušuje integraci. Můžeme definovat vektorová pole v indexu, která automaticky používají OpenAI pro vytváření embeddingů při indexování dokumentů.
Microsoft Ignite 2025: Posun od AI experimentů k firemním agentům nové generace
1. AI agenti přechází do hlavní role
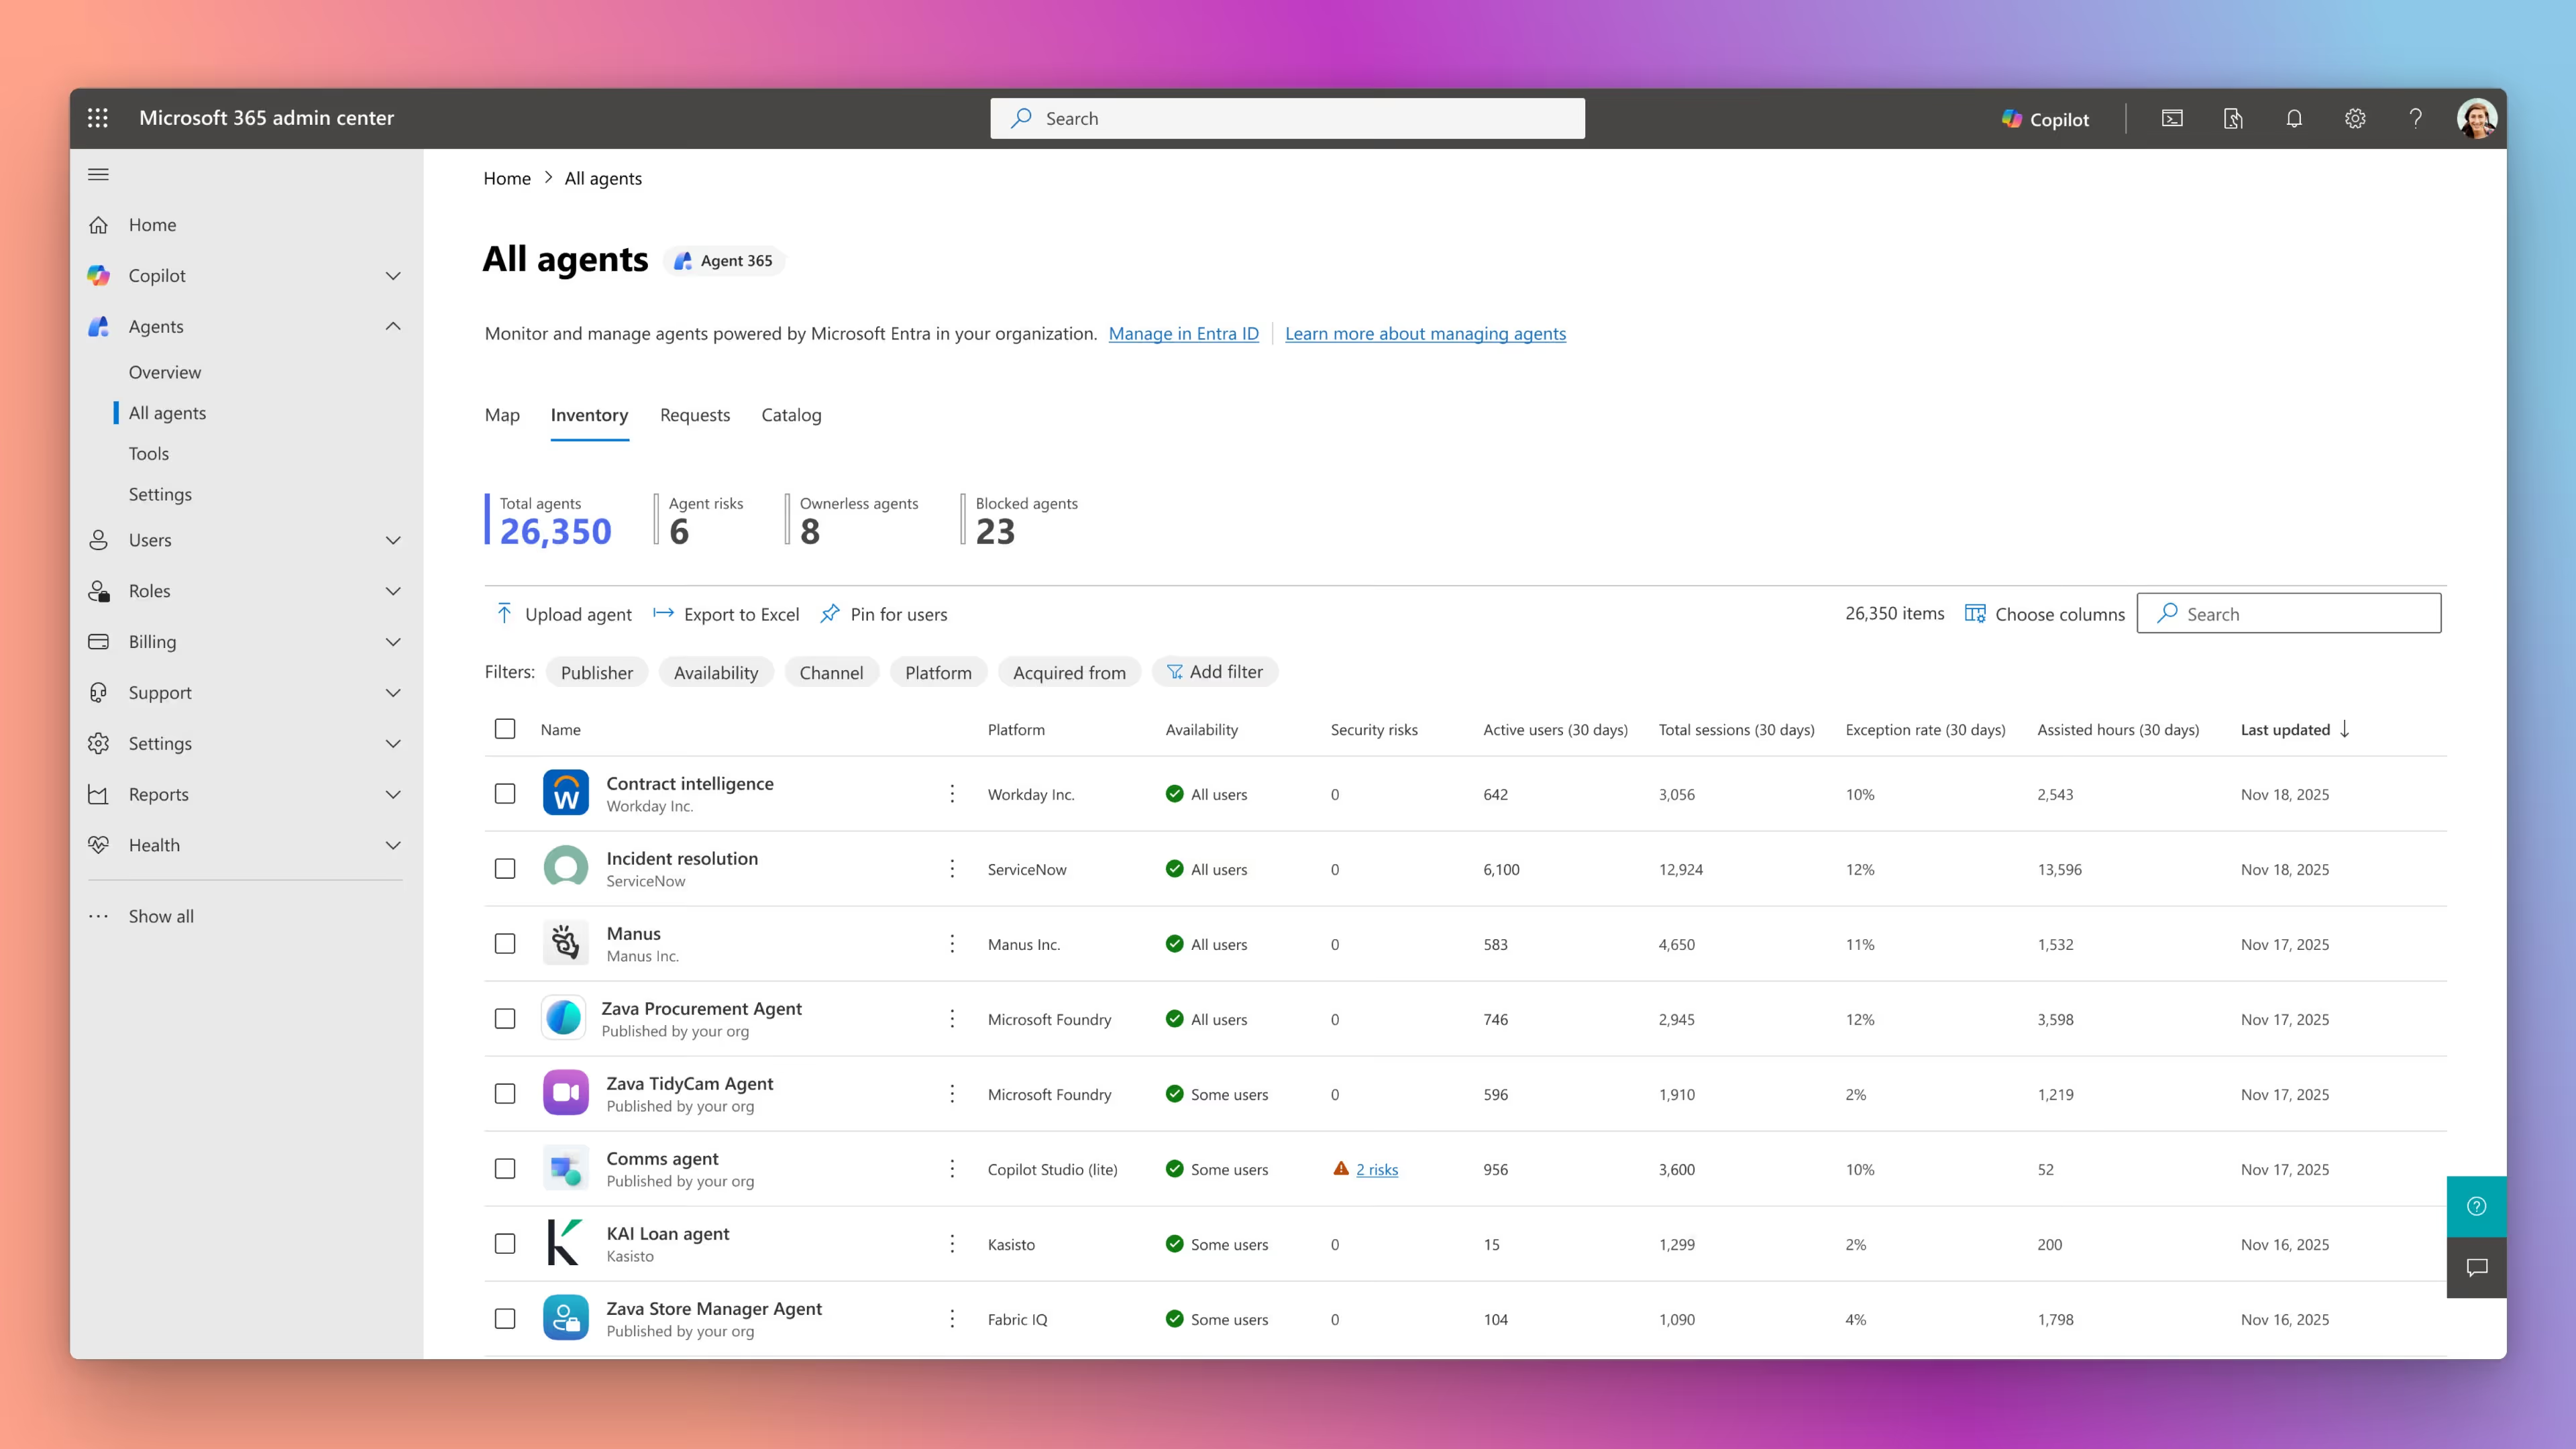
Hlavním oznámením Microsoftu byl Agent 365, který staví AI agenty do role nové provozní vrstvy digitálního pracovního prostředí. Nabízí centrální místo pro registraci, monitoring, zabezpečení a koordinaci agentů napříč organizací.
Zároveň Microsoft 365 Copilot představil dedikované agenty pro Microsoft Word, Excel a PowerPoint – schopné autonomně generovat, restrukturalizovat a analyzovat obsah podle firemního kontextu.
Proč je to důležité
Uživatelé se posouvají od „ptaní se AI“ k „zadávání práce AI“. Agentní architektury postupně nahradí mnoho jednoúčelových copilotů.
Co mohou firmy udělat
- identifikovat workflow vhodné pro autonomní agenty
- standardizovat chování a oprávnění agentů
- rozhodnout, které workflows je vhodné pro Agent 365
- spustit pilotní nasazení v rámci Microsoft 365
2. Integrace a orchestrace se stávají nezbytností
Microsoft také zdůraznil interoperabilitu skrze Model Context Protocol (MCP). Agenti v Microsoft Teams, Microsoft 365 i třetích stranách mohou sdílet kontext a provádět koordinované vícekrokové workflow.
Proč je to důležité
Skutečná automatizace vyžaduje orchestraci nástrojů, datových zdrojů a týmů – ne izolované asistenty.
Co mohou firmy udělat
- zmapovat workflow napříč aplikacemi
- propojit nástroje produktivity s CRM/ERP a dalšími systémy
- navrhnout agentní ekosystém místo samostatných botů
3. Governance a bezpečnost v popředí
S rostoucí autonomií agentů Microsoft přinesl nové governance možnosti:
- přehled o oprávněních agentů
- monitoring jejich chování
- integrace s Microsoft Defender, Entra a Purview
- centrální řízení politik
- ochrana proti úniku dat
Oficiální Microsoft článek se všemi novinkami ohledně bezpečnostních novinek - Link
Proč je to důležité
AI ve velkém měřítku musí být plně dohledatelná, bezpečná a v souladu s regulacemi.
Co mohou firmy udělat
- definovat, kdo může agenty vytvářet a upravovat
- nastavit auditní a monitorovací standardy
- vytvořit bezpečnostní mantinely ještě před širokým nasazením
4. Windows, Cloud PC a vzestup AI-first pracovního prostředí
Microsoft prezentoval Windows 11 a Windows 365 jako klíčové komponenty pracovního prostředí připraveného na AI. Novinky zahrnují:
- AI-vylepšené Cloud PC
- podporu sdílených a frontline zařízení
- lokální inference agentů na podporovaném hardware
- automatizaci na úrovni endpointu
Proč je to důležité
Distribuované týmy získají konsistentní a bezpečné prostředí s nativní AI podporou.
Co mohou firmy udělat
- zhodnotit využití Cloud PC ve svém prostředí
- modernizovat digitální workplace pro AI workflow
- zvážit AI-ready zařízení pro provozní týmy
5. AI infrastruktura a vývoj Azure
Microsoft Ignite přinesl další posun v Azure AI, včetně:
- rychlejšího a stabilnějšího hostingu a verzování modelů
- hybridního CPU/GPU inferencování
- efektivnějších deployment pipeline
- úspornějšího fine-tuningu
- vylepšené governance trénovacích datasetů
Celý report najdete zde - Link
Proč je to důležité
Robustní datová a modelová infrastruktura je základem pro agentní ekosystém.
Co mohou firmy udělat
- modernizovat datovou architekturu pro AI-ready stav
- implementovat vektorové vyhledávání a RAG pipeline
- optimalizovat náklady na provoz modelů
6. Copilot Studio a ekosystém pluginů se výrazně rozšiřují
Copilot Studio prošlo výraznou modernizací a posunulo se směrem k centrálnímu integračnímu a automatizačnímu nástroji. Novinky zahrnují:
- vizuální tvorbu vlastních agentů
- no-code vícekrokové workflow
- pluginy propojené s interními API
- lepší grounding a práci s podnikovými daty
- rozšířenou sadu konektorů pro CRM/ERP/event platformy
Proč je to důležité
Firmy mohou vytvořit oborové asistenty napojené na interní systémy a procesy.
Co mohou firmy udělat
- vyvíjet specializované copiloty pro konkrétní role a oddělení
- integrovat stávající systémy skrze konektory
- využívat vizuální logiku pro rychlé prototypy
7. Propojení Fabric a Azure AI na nové úrovni
Microsoft Fabric přidal výrazné AI funkce:
- hlubší propojení s Azure AI Studio
- automatizované pipeline pro přípravu dat pro AI
- vektorové indexy a RAG v rámci OneLake
- posílenou datovou lineage a governance
- lepší výkon analytiky ve velkém měřítku
Proč je to důležité
AI agenti potřebují čistá, aktuální a dobře spravovaná data. Fabric umožňuje vytvořit a spravovat konsolidované prostředí pro data i AI.
Co mohou firmy udělat
- konsolidovat roztříštěné pipeline do Fabricu
- implementovat interní znalostní vyhledávání pomocí RAG
- vytvářet governance-ready AI datasety
Co to znamená pro firmy
Napříč všemi novinkami je jasné, že AI se stává provozní vrstvou, nikoli doplňkem.
Firmy by měly počítat s tím, že:
- přichází přesun od experimentů k reálnému nasazení
- multi-agentní ekosystémy porostou rychleji
- governance je základní podmínka škálování
- propojení nástrojů a dat je zásadní
- AI bude součástí nástrojů, které lidé používají každý den
- konkurenční výhodu určí kvalita workflow, ne samotný model
Jak se připravit na rok 2026
Doporučené kroky:
1. Zmapujte workflow s vysokou hodnotou pro agentní automatizaci
Identifikujte opakované a mezi-týmové procesy, kde autonomní agenti přinášejí největší efekt.
2. Vytvořte governance framework pro agenty
Nastavte role, oprávnění, audit, monitoring a provozní dohled.
3. Připravte datovou infrastrukturu
Zajistěte kvalitní, spravovaná a přístupná data, která mohou agenti bezpečně využívat.
4. Integrujte produktivní nástroje
Propojte Microsoft Teams, Microsoft 365 a MCP-kompatibilní aplikace pro plynulý provoz.
5. Začněte pilotem
Vyberte jednu oblast nebo tým a otestujte agentní workflow pod dohledem.
6. Plánujte škálování
Po ověření guardrailů začněte agentní systém rozšiřovat do dalších částí firmy.
Od teorie k praxi: Jak BigHub připravuje studenty FJFI ČVUT na svět dat a AI
Propojení akademické sféry a praxe je klíčové
Od akademického roku 2021/2022 zde jako BigHub vyučujeme celosemestrální kurzy, které propojují akademickou půdu s reálným světem dat. A není to jen o přednáškách – studenti si sami vyzkouší, jak vypadá práce s daty v podnikovém prostředí, s reálnými technologiemi a pod vedením lidí, kteří podobné projekty řeší každý den.
Co nás na „Jaderku“ přivedlo
BigHub má k FJFI ČVUT osobní vztah. Mnozí z nás – včetně CEO Karla Šimánka, COO Ing. Tomáše Hubínka a více než deseti dalších – jsme na Jaderce sami studovali. Víme, že fakulta vychovává špičkové matematiky, fyziky a inženýry. Ale zároveň víme, že právě těmto studentům někdy chybí vhled do toho, jak svět dat a AI funguje v byznysu.
Proto jsme se rozhodli to změnit. Ne jako náborovou kampaň, ale jako dlouhodobý příspěvek českému školství. Chceme, aby studenti viděli reálné příklady, vyzkoušeli si moderní nástroje a lépe se připravili na start kariéry.
Dva předměty, dva semestry
18AAD – Aplikovaná analýza dat (letní semestr)
První předmět jsme otevřeli v akademickém roce 2021/2022. Vede ho Ing. Tomáš Hubínek a jeho cílem je dát studentům přehled o tom, jak vypadá práce s daty ve velkém měřítku. Mezi probíraná témata patří:
● organizace a ukládání dat,
● frameworky pro výpočty nad velkými daty,
● analýza grafů,
● cloudové služby,
● základy AI a ML.
Velký důraz klademe na praktická cvičení. Studenti pracují v prostředí Microsoft Azure, zkoušejí si různé technologie a mají prostor pro diskusi. Na vybrané přednášky zveme i další kolegy z BigHub, aby sdíleli zkušenosti z konkrétních projektů.
18BIG – Big Data nástroje a architektura (zimní semestr)
V roce 2024 jsme přidali druhý předmět, který na 18AAD volně navazuje. Výuku vedou doc. Ing. Jan Kučera, CSc. a doc. Ing. Petr Pokorný, Ph.D . Předmět jde více do hloubky a soustředí se na:
● data governance a práce s daty v organizaci,
● integrační architektury,
● datové platformy a příprava pro AI aplikace,
● best practices z reálných firemních projektů.
Zatímco 18AAD ukazuje, co vše se dá s daty dělat, kurz 18BIG učí a představuje, jak to reálně funguje ve firmě.
Nadstandardní zájem studentů
Volitelných předmětů FJFI se běžně účastní jen několik málo studentů. Na našekurzy se ale každý rok hlásí 20–35 studentů, což je na poměry fakulty nadstandard.
Zpětná vazba je konzistentní – studenti oceňují praktický přesah, otevřenost diskuse a možnost ptát se lidí z praxe na konkrétní situace. Pro mnohé jde o první kontakt s technologiemi, které firmy skutečně používají.

Přesah do studijních programů
Naše role nekončí u přednášek. Společně s katedrou softwarového inženýrství jsme pomáhali revidovat studijní programy a profil absolventů. Fakulta tak může pružněji reagovat na to, co firmy v oblasti dat a AI potřebují. Díky tomu se posouvá kvalita vzdělávání celé fakulty, tedy nejen u studentů, kteří si zvolí naše volitelné předměty.
Není to o náboru
Občas se stane, že některý ze studentů najde cestu do BigHub, ale to není hlavní cíl. Jde o to, aby studenti po škole nebyli překvapení, jak se s daty skutečně pracuje. Chceme, aby měli širší a praktičtější znalosti a zkušenost s moderními nástroji. Dáváme tak něco zpět místu, které nás vychovalo, a věříme, že to pomůže celé české technologické scéně.
Spolupráce s FJFI není jen o výuce. Prakticky od vzniku BigHub podporujeme také studentskou unii a účastníme se sportovní akce Pohár děkana FJFI, kde každoročně hrajeme futsal, beach volejbal a další sporty. Letos jsme navíc společně s FJFI podali několik dotačních žádostí a věříme, že se brzy zapojíme do společných technických projektů. Razíme myšlenku, že silná komunita a neformální propojení studentů s lidmi z praxe jsou stejně důležité jako znalosti v učebnicích.

Co plánujeme dál?
Naše spolupráce s FJFI ČVUT je dlouhodobá. Kurzy 18AAD a 18BIG poběží i v dalších letech a přemýšlíme, jak rozšířit jejich záběr.
Vidíme, že studenti mají hlad po praktických zkušenostech a že propojení akademie s praxí funguje. Pokud se díky tomu v budoucnu zlepší kvalita datových a AI projektů v českých firmách, bude to nejlepší důkaz, že naše úsilí má smysl.
EU AI Act: Co to je, koho se týká a jak ho vaší firmě pomůžeme zvládnout bez stresu
Co je AI Act a proč vznikl
AI Act je první ucelený zákon Evropské unie, který stanovuje pravidla pro vývoj a používání umělé inteligence. Myšlenka za vznikem této legislativy je zřejmá: jen díky jasným pravidlům může být AI pro firmy i jejich zákazníky bezpečná, transparentní a etická.
Umělá inteligence dnes proniká do stále více oblastí života i podnikání, a proto EU chce, aby její používání i rozvoj probíhal zodpovědně a bez rizika zneužití, diskriminace či jiných negativních dopadů. AI Act má chránit spotřebitele, posilovat férovou konkurenci a nastavit jednotná pravidla pro všechny členské státy Evropské unie.
Koho se AI Act týká
Ďábel se často skrývá v detailu, což trochu platí také o AI Actu. Tato legislativa totiž nedopadá jen na firmy vyvíjející umělou inteligenci, ale i na ty, které ji jakkoliv používají ve svých produktech, službách nebo interních procesech. Typicky se tak souborem zákonů AI Act musí řídit podniky, které například:
- vyvíjí AI
- používají AI pro rozhodování o lidech (např. nábor nebo hodnocení výkonu zaměstnanců)
- automatizují zákaznické služby (např. chatboti nebo hlasoví asistenti)
- zpracovávají pomocí AI citlivá data
- integrují AI do produktů a služeb
- provozují AI systémy třetích stran (např. nasazení hotových AI řešení od externích dodavatelů ve vlastním podnikání)
AI Act samozřejmě rozlišuje běžný software od AI systému, takže je vždy potřeba zjistit, jestli dané řešení pracuje autonomně a adaptivně (tzn. učí se z dat a optimalizuje své výsledky), nebo pouze vykonává předem definované instrukce a nesplňuje tak definici AI řešení.
Mimochodem: legislativa se vztahuje nejen na nové, ale i na již existující aplikace využívající AI (včetně machine learningu).
Abyste s těmito starostmi nemuseli trávit desítky hodin času a strachovat se, jestli vše splňujete, jak máte, v BigHub implementaci AI Act rádi vyřešíme za vás.
Co konkrétně AI Act reguluje
Legislativa AI Act definuje spoustu detailních požadavků, těmi vás teď ale nechceme zatěžovat. Pro firmu využívající AI je důležité vědět, že se AI Act zabývá několika hlavními kategoriemi.
1. Klasifikace rizik
Legislativa používá stupnici rizikovosti AI řešení, od minimálně rizikových až po velmi rizikové, nebo dokonce zakázané.
2. Povinnosti vývojářů i provozovatelů AI
Například dodržování bezpečnostních norem, pravidelná dokumentace nebo zajištění přísného dohledu.
3. Transparentnost a vysvětlitelnost
Uživatelé AI nástrojů musí vědět, že komunikují s umělou inteligencí.
4. Zakázané aplikace AI
Například systémy, které manipulují lidským chováním či cíleně diskriminují určité skupiny.
5. Monitorování a hlášení incidentů
Udává firmám povinnost hlásit nežádoucí události a nesprávné fungování AI systémů.
6. Zpracování citlivých dat
AI Act reguluje používání osobních, biometrických či zdravotních údajů všech lidí, kteří s nástroji umělé inteligence pracují.
Vyhněte se obrovským pokutám
Sankce za nedodržování pravidel stanovených AI Act jsou vysoké, konkrétně vás mohou stát až 7 % z celosvětového obratu firmy, což v případě některých firem činí i miliony eur.
Proto doporučujeme nad novými AI regulacemi nemávnout rukou a včas je implementovat na všech místech ve firmě, kde využíváte umělou inteligenci.
Přehoďte starosti se zaváděním regulace AI Act na nás
Nemáte desítky hodin času studovat složité zákony a nechcete riskovat, že vaše firma dostane vysokou pokutu? Přehoďte starosti se záváděním regulace AI Act na nás.
Ve spolupráci s největší česko-slovenskou (s mezinárodní působností) advokátní kanceláři HAVEL & PARTNERS, zákazníkům po celém světě dlouhodobě pomáháme zavádět osvědčené postupy a frameworky, zrychlovat inovace a optimalizovat procesy, takže rádi budeme k ruce i vám.
- AI pro vás vyřešíme „na klíč“, kromě vývoje AI řešení se postaráme také o zapracování regulace AI Act. Celým procesem vás postupně provedeme.
- Vytvoříme vaší firmě interní směrnice na využívání AI.
- Provedeme audit AI aplikací, které již používáte.
- Vaše současné i nově implementované AI aplikace nastavíme tak, aby byly v souladu s AI Act.
- Posoudíme za vás rizika, abyste věděli, která AI řešení a jak můžete používat.
- Pomůžeme vám se zmapováním současné situace i s tvorbou nezbytné dokumentace či procesních povinností.
Databricks Mosaic vs. Custom Frameworky: Jak vybrat správnou cestu pro GenAI
Proč firmy volí Databrics Mosaic
Pokud má organizace již vybudovanou datovou platformu na Databricks, je logické zvážit i Mosaic. Využití jedné technologie přináší architektonickou čistotu, jednodušší správu a rychlý start.
Databricks Mosaic má nesporné výhody:
- Jednoduchost: tvorba interních chatbotů a základních agentů je rychlá a přímočará.
- Governance by design: logování, lineage a kontrola nákladů jsou zabudované.
- Integrace s daty: MCP servery a SQL funkce umožňují agentům pracovat s firemními daty bez složitého vývoje.
- Vývojářská podpora: funkce jako Genie (konkurence Fabric Copilot) nebo assisted debugging reálně zrychlují práci vývojářů.
Pro jednodušší scénáře – například interní asistenty nad firemními daty – je Databricks Mosaic rychlým a efektivním řešením. I my v BigHubu jsme Databricks Mosaic nasadili například u velkého výrobního podniku nebo retailové společnosti, kde šlo o jednoduché dotazování do firemních dat.
Kde Databricks Mosaic nestačí
Složitější projekty ale kladou jiné nároky – na latenci, přesnost, multiagentní logiku či integraci do stávajících systémů. A zde Mosaic naráží na své limity:
- Strukturovaný output: Databricks Mosaic neumí efektivně vynutit strukturovaný výstup, která se projeví v kvalitě výstupu či provozní stabilitě různých řešení (např. voiceboti či OCR)
- Vícekrokové workflow: procesy jako likvidace pojistných událostí nebo úpisy jsou v Databaricks Mosaic buď nemožné, nebo zbytečně složité.
- Latency-critical scénáře: Databricks Mosaic přidává další vrstvu mezi uživatele a model, což komplikuje nízkolatenční aplikace.
- Integrace mimo Databricks: pokud firma nechce využívat jen Vector Search a Unity Catalog, je propojení s dalšími systémy složitější než v čistém Python frameworku.
- Omezený katalog modelů: dostupných modelů je zatím jen několik, nelze připojit vlastní ani ty z jiných cloudů.
Databricks přitom sám uvádí, že Mosaic nemá ambici nahradit specializované frameworky – a do jisté míry je to pravda. Překryv ale existuje a v těchto složitějších případech Mosaic zatím ztrácí flexibilitu.
Kde dává smysl custom framework
Custom framework má největší výhodu tam, kde projekt vyžaduje komplexní logiku, multiagentní orchestraci nebo nízkou latenci.
- Více agentů: spolupráce agentů s různými rolemi a dovednostmi.
- Streaming a realtime: nezbytné pro call centra, voiceboty či fraud detection.
- Custom logika: přesně definované workflow a vícekrokové procesy.
- Regulační compliance: transparentní auditovatelnost podle AI Act.
- Flexibilita: využití jakýchkoliv knihoven, modelů a architektur bez vendor lock-inu.
To ale neznamená, že Databricks Mosaic nelze využít i pro byznysově komplexní případy. U některých scénářů to možné je. Pokud se ale řeší aplikace, kde rozhoduje latence, strukturovaný výstup nebo přesnost, Databricks Mosaic dnes spíše pokulhává.
Jak to řeší BigHub
V BigHubu jsme přesvědčeni, že neexistuje univerzální odpověď. Databricks Mosaic má své místo a v řadě projektů či scénářů ho bez váhání a úspěšně využíváme. Pak jsou ale situace, kdy doporučíme customizovaný framework, protože je to pro klienta dlouhodobě nejefektivnější cesta.
- Výrobní podnik a retail: Databricks Mosaic jsme využili pro interní asistenty nad firemními daty (SQL queries). Nasazení bylo rychlé, governance je vestavěná a pro tento typ dotazů fungoval velmi dobře.
- Pojišťovnictví (likvidace škod): Zde Databricks Mosaic nestačil – chyběl structured output, víceagentní orchestrace i práce s hlasem. Custom framework nám umožnil přesnost, vícekrokovou logiku a auditovatelnost podle AI Act.
- Bankovnictví (úpisy): Procesy vyžadující vícekrokové workflow a integraci do core systémů jsou v Databricks Mosaic zbytečně složité. Využili jsme vlastní middleware, který zvládá více agentů i modely z různých cloudů.
- Call centra a OCR: Latency-critical aplikace nebo scénáře vyžadující strukturovaný výstup (např. extrakce dat z dokumentů, voiceboti) Databricks Mosaic nepodporuje. Tyto případy vždy řešíme custom řešením.
Naše role je v tom, že klienta netlačíme do jedné technologie. Pomůžeme rozhodnout, kdy se vyplatí Databricks Mosaic a kdy je nutné jít cestou custom. Díky tomu dokážeme zajistit rychlý start i dlouhodobou udržitelnost.
Naše doporučení
- Databricks Mosaic: vhodný pro firmy s Databricks ekosystémem, které chtějí rychle spustit interní asistenty nebo jednodušší agenty s dobrou správou a governance.
- Custom framework: lepší volba tam, kde jsou potřeba složité vícekrokové procesy, multiagentní orchestrace, strukturovaný výstup nebo nízká latence.
BigHub oba přístupy zná z praxe. Proto našim klientům nepřinášíme jen technologii, ale hlavně kompetenci vybrat tu správnou kombinaci pro jejich konkrétní situaci.
MCP změní pravidla hry. Weby a appky už nestačí.
Co je vlastně MCP – a proč na něm tolik záleží?
Model Context Protocol může znít jako technologie z akademické laboratoře nebo interní dokumentace velkých technologických firem. Ve skutečnosti jde ale o standard, který umožňuje různým AI systémům vzájemně spolupracovat – ať už jde o komunikaci s lidmi, API, nástroji nebo mezi sebou navzájem. Zatímco dnes většina AI nástrojů funguje jako samostatné chatboty, hlasoví asistenti nebo úzce zaměřené moduly, MCP umožňuje, aby se tyto systémy propojily do inteligentního ekosystému, který funguje napříč službami i firmami. Výsledek?
Například:
- Získáte stav objednávky z e-shopu
- Zkontrolujete pojistnou smlouvu
- Přesunete termín návštěvy u lékaře
- Zařídíte platbu, dopravu i potvrzení – bez jediného přepnutí mezi aplikacemi
To vše bez toho, aby každá firma musela vyvíjet vlastní umělou inteligenci. Stačí, že své služby a data zpřístupní standardizovanou cestou.
Změna paradigmatu: z „AI jako pomocníka“ na „AI jako rozhraní“
Doposud firmy využívaly umělou inteligenci hlavně jako nástroj pro podporu zaměstnanců – zrychlit vyhledávání, usnadnit rozhodování nebo analyzovat data. MCP ale umožňuje posun: uživatel nebude komunikovat s firmou, ale přes své vlastní AI rozhraní. Firmy tedy nebudou budovat AI pro sebe, ale otevřou přístup ke svým službám – a uživatelé s nimi budou komunikovat přes své vlastní systémy: osobní digitální asistenty, voice interface, AI rozšíření, apod.
Je to podobná revoluce, jako když web nahradil telefonní linky a mobilní aplikace přepsaly způsob, jak si objednáváme jídlo nebo taxi. MCP dělá totéž – ale pro celý provoz firmy.
AI-first svět je blíž, než si myslíme
Dříve jsme hledali přes Google. Dnes stále více lidí sahá nejdřív po ChatGPT, Perplexity nebo jiném osobním AI rozhraní. Vstupní bod do digitálního světa se mění – už to není web nebo appka, ale AI, která nás zná. Firmy, které na to nejsou připravené, ztratí přístup k zákazníkovi už v prvním kroku. Podobně jako zaspaly ty, které podcenily mobilní revoluci.
Co to znamená pro firmy?
1. Už nebudete muset vyvíjet vlastního chatbota
Místo investic do vývoje vlastních rozhraní, UX, dialogů a modelů budou firmy poskytovat přístup ke svým službám. Uživatelská zkušenost bude řešena na straně klienta – firmě zůstane to nejcennější: jádrové služby, procesy a data.
2. Zmizí potřeba tradičních call center
Zákazníci nebudou volat na linku. Zavolají své AI – a ta se sama napojí na systémy firmy, zjistí potřebné informace nebo požádá o akci. Vše během sekund. Místo front a čekání vznikne automatizovaná a přímá interakce bez operátora.
3. Otevírají se nové možnosti monetizace a reputace
Protože uživatel bude přicházet s vlastním inteligentním rozhraním, firmy nebudou nést reputační riziko „hloupého bota“. Současně budou mít plnou kontrolu nad tím, co a komu otevřou – a tím i nové možnosti personalizace a monetizace.
Co to znamená pro běžné lidi?
- Jedno rozhraní pro všechny služby
- Místo desítek aplikací a přihlašování budete mít jedno AI rozhraní, které obslouží vše.
- Plná autonomie
- Objedná zboží, porovná nabídky, zařídí reklamaci nebo naplánuje službu – bez potřeby lidského zásahu.
- Chytřejší rozhodování
- AI ví, co preferujete, zná vaši historii i cíle – a navrhuje nejlepší řešení.
Praktický příklad:
Vaše AI rozhraní vám doporučí recept, zjistí, co vám chybí doma, porovná ceny na několika e-shopech, vybere nejvýhodnější variantu a objedná – bez nutnosti manuálního klikání.
O čem se zatím moc nemluví: data
Aby to celé fungovalo, budou muset uživatelé i firmy řešit důvěru a přístup k datům. MCP v tomto nabízí jasný rámec – umožňuje bezpečné, transparentní a škálovatelné sdílení dat i operací mezi systémy, bez potřeby replikace nebo rizika úniku.

Napište si o nezávaznou konzultaci zdarma
Chcete s námi probrat podrobnosti? Vyplňte krátký formulář níže a my se vám brzy ozveme, abychom si s vámi domluvili termín nezávazné online konzultace zdarma.
