

BigHub blog – čtěte, objevujte a nechte se inspirovat.
Novinky z oboru, rozhovory, technologické zajímavosti a spousta dalších přínosných informací.
10 signálů, že vaše data nejsou připraveny na AI (a jak každou z nich vyřešit)
Firmy, které dnes z AI získávají největší hodnotu, nemají nutně lepší modely. Mají lepší datové základy.
Je dobré si přiznat, jak výrazně se samotný model propadl na seznamu věcí, které rozhodují o úspěchu AI projektu. Nejnovější jazykové a embeddingové modely jsou dnes dostupné prakticky všem a působivé demo lze postavit během několika dní.
Demo je jednoduché. Systém za ním už ne. Rozdíl mezi proof of conceptem a řešením, kterému může velká firma skutečně důvěřovat, proto většinou není v modelu. Rozhoduje, jestli se AI může opřít o data, která lze používat opakovaně, bezpečně a konzistentně.
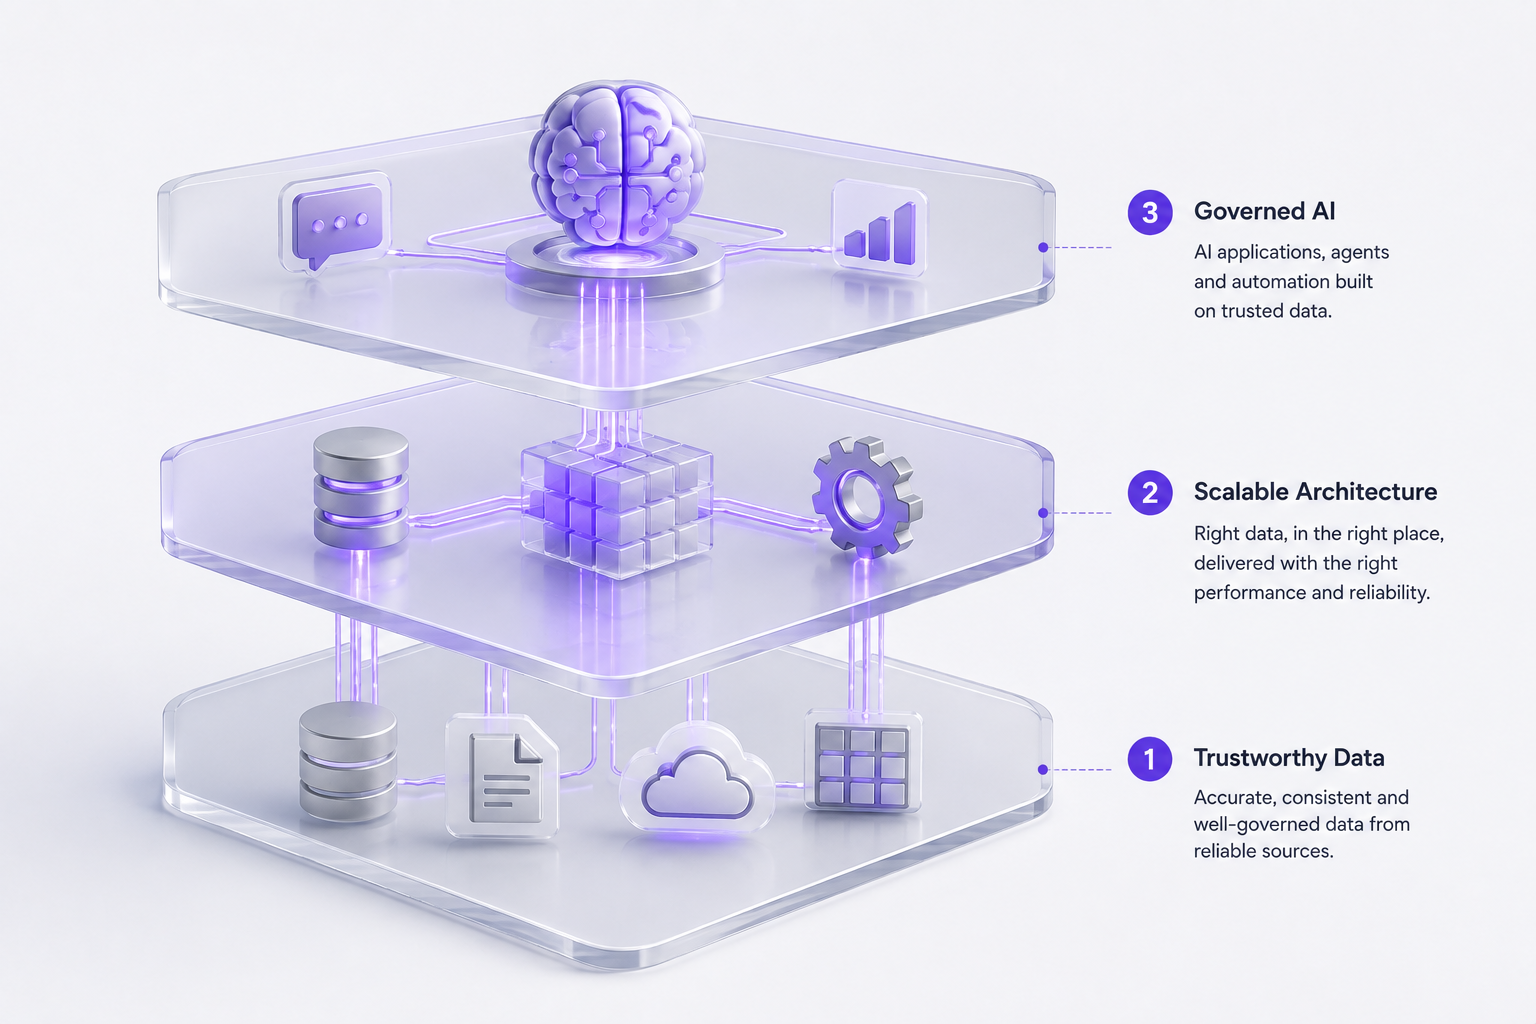
Napříč více než 500 projekty pro více než 100 velkých firem od roku 2016 se opakovaně setkáváme se stejnými varovnými signály. Spadají do tří oblastí: zda lze věřit samotným datům, zda je současná architektura dokáže správně poskytovat a zda AI umí bezpečně pracovat s firemními znalostmi. Tady je deset nejdůležitějších a konkrétní doporučení, jak je řešit.
Nejdřív musíte věřit vlastním číslům
Ještě před architekturou a modely si položte jednodušší otázku: věří lidé ve vaší firmě číslům, se kterými už dnes pracují? Často ne. A AI tento problém velmi rychle odhalí.
1. Stejné KPI znamená pro každý tým něco jiného
Zeptejte se tří oddělení na tržby za minulý měsíc a možná dostanete tři různá čísla. Finance počítají vyfakturované tržby bez DPH, obchod pracuje s uzavřenými objednávkami a dashboard ukazuje ještě třetí hodnotu. Dlouho se s tím dalo žít, protože někdo v místnosti obvykle věděl, které číslo je v daném kontextu správné. AI asistent takový instinkt nemá. Použije definici, ke které dostal přístup. Jakmile vedení firmy dostane od stejného systému dvě protichůdné odpovědi, důvěra v něj mizí velmi rychle.
Řešení je méně technické, než se může zdát. Pro klíčové metriky stanovte jednu společnou definici a jasného vlastníka. Jakoukoli změnu definice řešte jako vědomé a komunikované rozhodnutí, ne jako úpravu, kterou si jeden tým provede sám pro sebe. Společný jazyk pro nejdůležitější KPI umožní AI spory o čísla řešit, ne vytvářet nové.
Co vidíme v praxi
Organizace se často domnívají, že mají problém s kvalitou dat.
Ve skutečnosti mají problém s konzistencí.
Data existují. Firma se prostě neshodne na tom, co znamenají.
2. Data vznikají jako reporty, ne jako datové produkty
V řadě firem data stále vznikají postaru. Někdo položí otázku, analytik vytvoří export, ručně ho vyčistí a pošle dál. Při další otázce celý proces začíná znovu. Samotný report nemusí být chybný. Problém je, že není znovu použitelný. Dva analytici tak mohou na stejnou otázku odpovědět dvěma různými čísly, aniž by bylo jasné, kdo za rozdíl odpovídá.
Přístup data jako produkt tento vztah mění. Kritický dataset už nevzniká pokaždé na objednávku, ale funguje jako dlouhodobě spravovaná služba. Má svého vlastníka, definovanou kvalitu a aktuálnost, jasný význam a plán dalšího rozvoje. Nejde o proces pro proces. Právě díky tomu se může AI zítra spolehnout na stejná data, ze kterých vycházela dnes.
3. Když se něco pokazí v datech, nikdo se to nedozví včas
Datové problémy většinou nepřicházejí s hlasitým alarmem. Feed dorazí pozdě, datová dávka se načte jen částečně nebo se nečekaně změní struktura některého pole. Dashboard přesto dál ukazuje číslo, jako by se nic nestalo.Ve světě reportingu si toho někdo dříve nebo později všimne. Ve světě AI už se mezitím chybná data mohla dostat do odpovědi zákazníkovi. Reporting dokáže pozdní data odpustit. AI ne.
První instinkt bývá monitorovat všechno. To ale většinou vede jen k záplavě alertů, které postupně všichni začnou ignorovat. Začněte datasety, na kterých závisejí vaše první AI use cases, a sledujte tři nejčastější problémy: zda data dorazila včas, zda se jejich objem výrazně neodchýlil od normálu a zda se bez upozornění nezměnila jejich struktura. Každý alert musí mít vlastníka a jednoduchý postup, co dělat dál. Monitorovat všechno vytváří šum. Monitorovat data, na kterých vaše AI skutečně závisí, vytváří důvěru.
I důvěryhodná data mohou narazit na špatnou architekturu
Řada firem si sjednotí definice a zlepší kvalitu dat, ale AI projekty přesto začnou narážet na další bariéru. AI totiž přináší typ workloadu, pro který většina současných datových systémů původně nevznikla. BI vysvětluje, co se stalo. AI stále častěji pomáhá rozhodovat o tom, co se má stát dál, a k tomu potřebuje vědět, co se děje právě teď. Právě tento rozdíl odhaluje limity architektury, které firmy dříve nemusely řešit.
Co vidíme v praxi
Firmy málokdy přestavují svou architekturu jen kvůli AI.
Častěji AI jen odhalí úzká hrdla, která tam byla vždy.
Architektura nebyla nikdy špatná. Byla jen postavena pro jiný typ otázek.
4. Všechno stále běží přes jeden monolitický datový sklad
Datový sklad je skvělý pro včerejšek. AI stále častěji potřebuje vědět, co se děje teď.
Klasický warehouse vznikal pro dávkové zpracování, historické agregace a SQL analytiku. Jakmile od něj začnete vyžadovat rychlé provozní dotazy s nízkou latencí, začnou se objevovat jeho limity. Platíte za výkonné úložiště i u dat, která takový výkon nepotřebují, eventová a nestrukturovaná data do něj zapadají obtížně a protože je velká část systému vzájemně propojená, jediná změna může ovlivnit desítky reportů. Všechno běží jednou rychlostí a ta jen málokdy odpovídá tomu, co potřebuje AI.
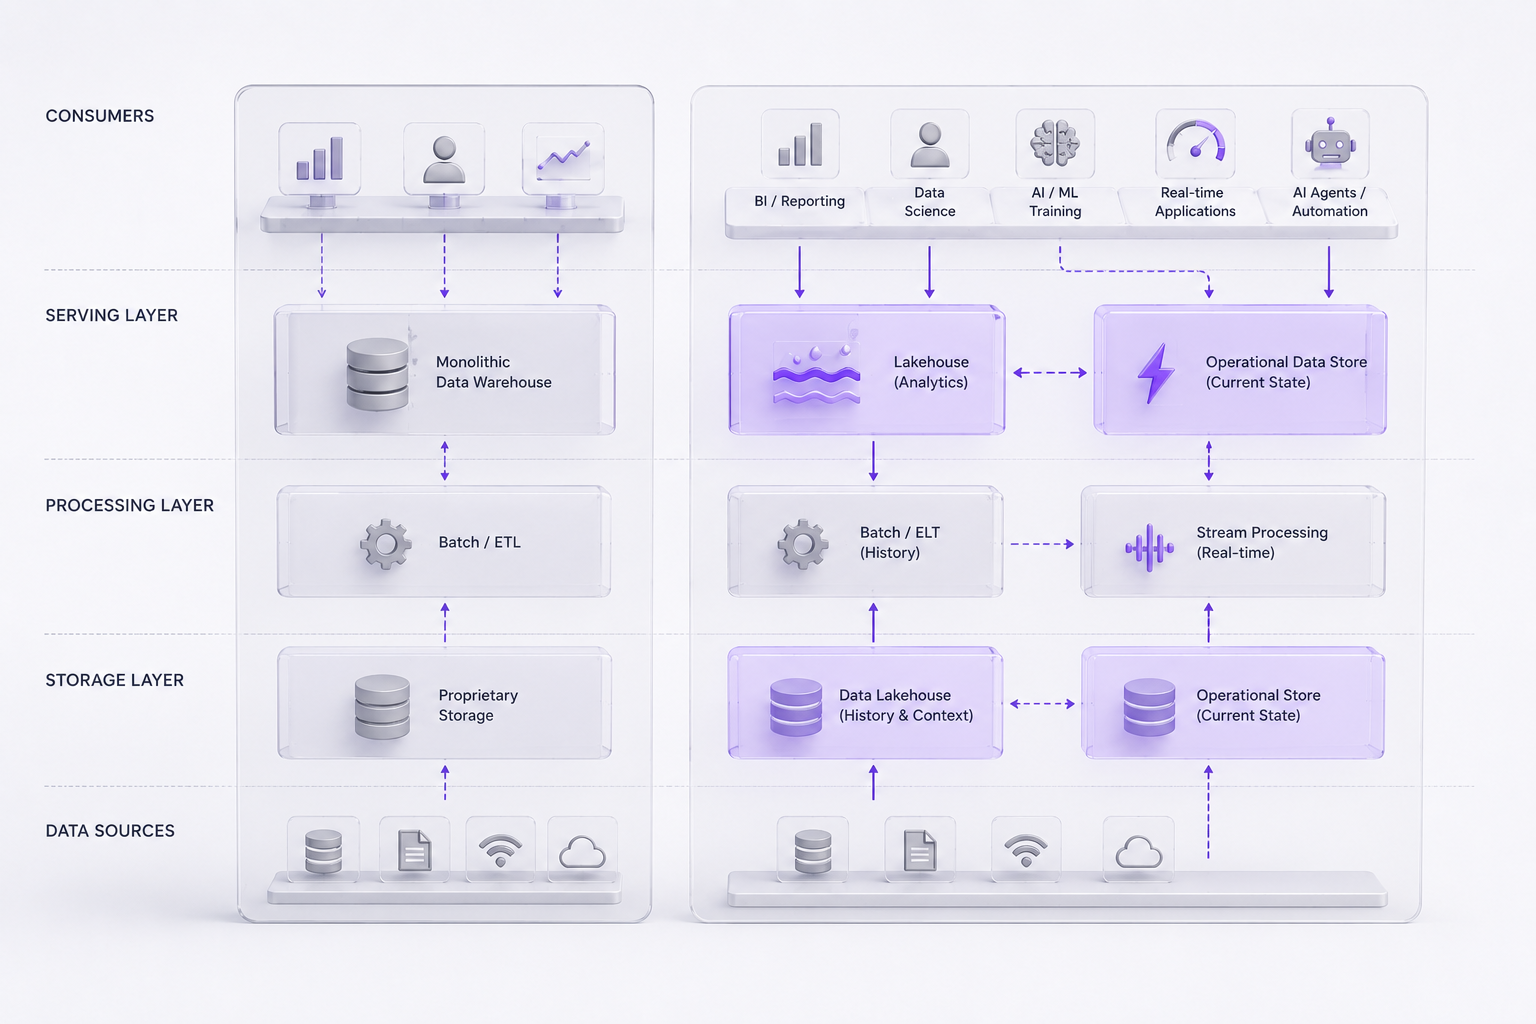
Řešením není další velká migrace. Je potřeba přijmout, že různé workloady mají různé požadavky. Historická analytika a operativní AI by neměly soupeřit o stejnou architekturu. Data mají svou „teplotu“. Historie, analytika a trénování modelů patří do lakehouse. Aktuální stavová data dávají větší smysl v rychlejší operativní vrstvě, která je pro tento účel navržená. Oddělením těchto dvou světů přestanete škálovat jeden drahý systém kvůli workloadům, které do něj nikdy nepatřily.
5. AI musí mít přístup k vašim klíčovým systémům, aby věděla, co se děje právě teď
Skutečná hodnota AI se často začne ukazovat ve chvíli, kdy dokáže odpovídat na provozní otázky. Vedoucí skladu chce vědět, které objednávky jsou právě teď blokované kvůli chybějícím zásobám. Likvidátor potřebuje zjistit, které případy dnes vyžadují manuální kontrolu. Finance se ptají, zda už byla konkrétní faktura zaplacena.
A právě tehdy řada firem zjistí, že jejich architektura nikdy nebyla navržená tak, aby dokázala bezpečně poskytovat aktuální provozní data. Jedinou možností pak bývá dotazovat se přímo ERP, CRM nebo SAPu. To může být pomalé, drahé a natolik rizikové, že to IT odmítne. A oprávněně.
Právě tady dává smysl operational data store (ODS). ODS funguje jako vrstva mezi core systémy a aplikacemi, které jejich data potřebují. Přes integrační vrstvu do něj proudí pouze relevantní aktuální stav. AI díky tomu dokáže rychle odpovídat na provozní otázky, aniž by zbytečně zatěžovala systémy, na kterých firma stojí. Zároveň vznikne jasná hranice mezi aktuálními provozními daty v ODS a historickými daty v lakehouse.
ODS ale nestavte pro všechno. Začněte třemi až pěti otázkami s nejvyšší obchodní hodnotou.
Co vidíme v praxi
Problém málokdy bývá technický.
Nikdo nikdy nemusel zpřístupnit provozní data mimo hlavní systém, takže neexistuje žádná bezpečná cesta, jak to udělat.
ODS je stejně tak organizační rozhodnutí jako architektonické.
6. „Real-time“ ve skutečnosti neznamená nic konkrétního
Téměř každá velká firma dnes tvrdí, že má real-time data. Když se ale zeptáte, co přesně tím myslí, definice se začne rozpadat. Pro jeden tým jde o kopii dat z core systémů aktualizovanou každých několik minut, pro jiný o hodinovou agregaci streamovaných dat. Další očekává event feed s garantovanou latencí v řádu sekund.
Někdy real-time vrstva existuje hlavně na architektonickém diagramu. Události sice proudí, ale není jasné kudy, nikdo nekontroluje jejich úplnost a nikdo nehlídá, zda skutečně dorazily včas. U AI může být důsledek nenápadný, ale drahý: systém reaguje pozdě a odpověď, která je technicky správná, už v okamžiku doručení nemusí platit.
Začněte proto definicí, ne technologií. Každý use case musí mít jasně stanovené, co pro něj „real-time“ znamená. Pak stačí relativně neatraktivní, ale spolehlivý základ: jasná cesta od zdroje ke konzumentovi, základní validace, monitoring úplnosti a včasnosti dat a člověk, který reaguje, když něco nefunguje. Poznáte, že systém funguje, když zpoždění zachytíte dřív než zákazník.
7. API vzniklo pro jednu aplikaci. A je to na něm vidět.
API je v mnoha firmách historický vedlejší produkt první webové nebo mobilní aplikace, která ho potřebovala. Funguje dobře, dokud se nepokusíte připojit něco dalšího: AI agenta, partnera nebo jiný interní tým. Pak začnou problémy. API je křehké, nemá verzování, každá změna rozbije jiného konzumenta a připojení čehokoli nového se mění v samostatný projekt. Právě tato třecí plocha často odděluje pilot od skutečného škálování.
Změna přístupu je jednoduchá: přestaňte API vnímat jako technické „potrubí“ jedné aplikace a začněte s ním pracovat jako s produktem. Stabilním, verzovaným a řízeným, navrženým kolem konkrétních business capabilities, ne jednotlivých kanálů. Pokud AI dostane stabilní rozhraní k aktuálním a jednoznačně definovaným datům, zmizí velká část workaroundů a ručně slepovaných integrací, na kterých AI projekty často zbytečně ztroskotají.
Co vidíme v praxi
Projekty AI málokdy selžou kvůli chybějícímu API.
Selhávají proto, že každé API bylo postaveno kolem jiné aplikace.
Řešením málokdy bývá více API. Řešením je méně, ale lepších API.
Jakmile AI začne pracovat s dokumenty, disciplína je důležitější než model
Strukturovaná data jsou pouze polovina problému. Velká část nejhodnotnějších AI use cases pracuje s dokumenty: interními směrnicemi, smlouvami, procesy, produktovou dokumentací nebo firemním know-how. A právě zde rozdíl mezi efektním demem a spolehlivým systémem téměř vždy stojí na disciplíně kolem dat.
8. AI odpovídá z vašich dokumentů. Nikdo ale neví z kterých.
Asistent sebevědomě odpoví na otázku týkající se HR směrnice nebo konkrétního ustanovení smlouvy. Odpověď zní správně. Nikdo ale nedokáže říct, z jakého dokumentu ji AI získala, a už vůbec ne, jestli je daný dokument stále platný.
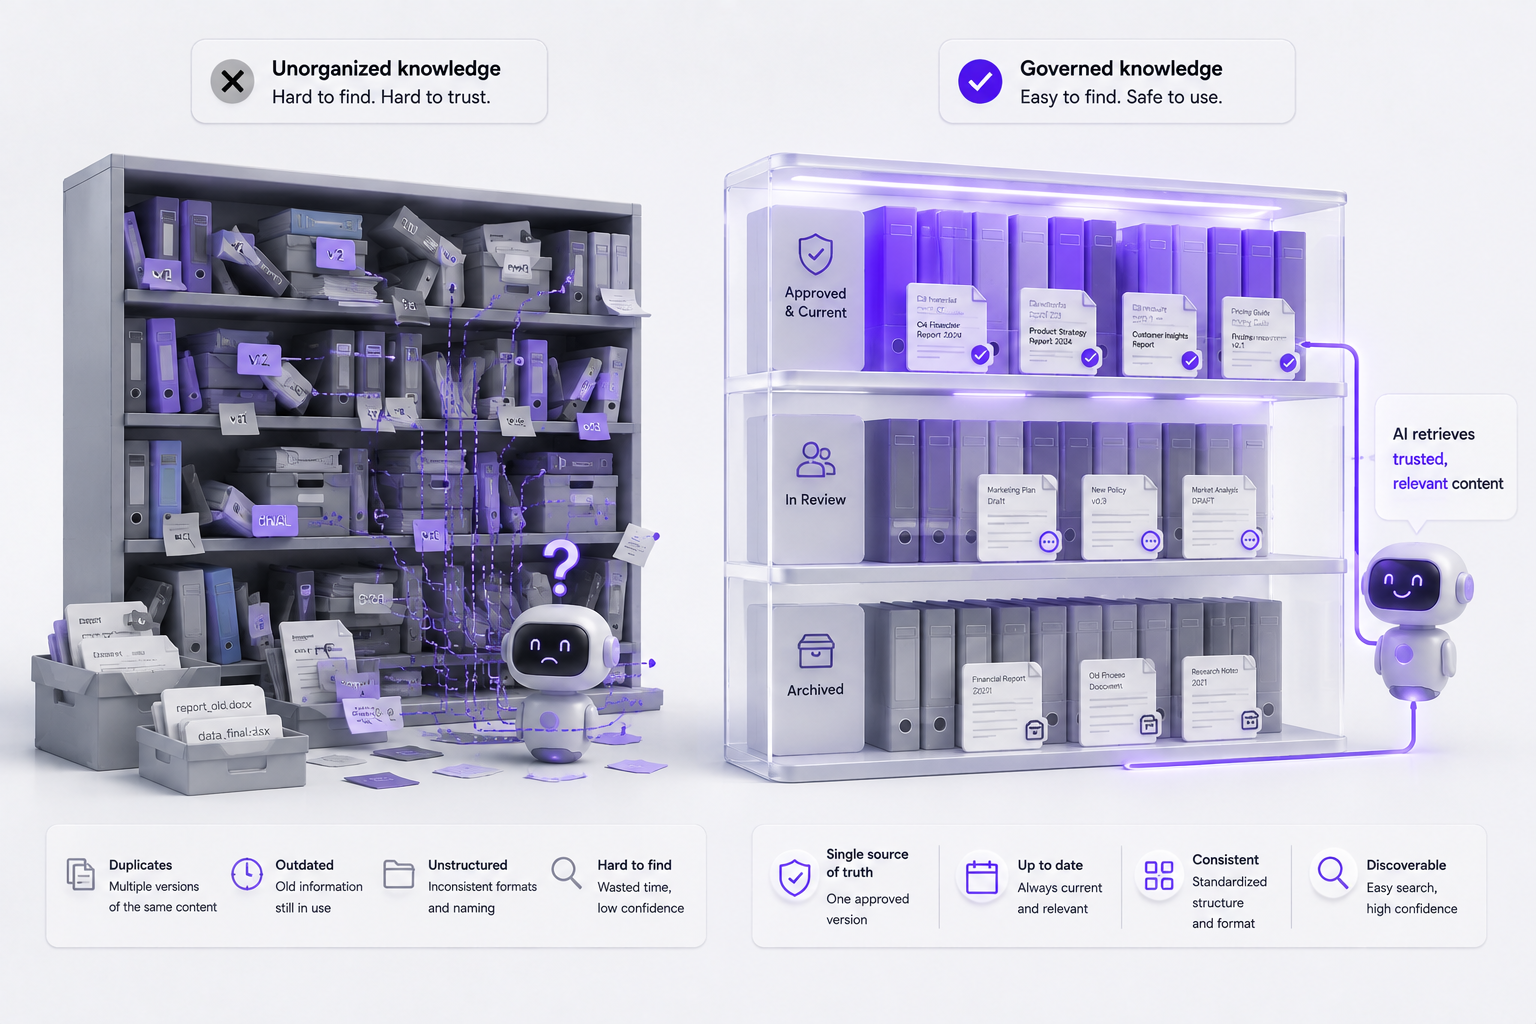
Z našich zkušeností bývá skutečným rizikem málokdy samotný model. Problémem je obsah pod ním: zastaralé soubory, několik verzí stejného dokumentu, chybějící source of truth nebo dokumenty bez jasného vlastníka. AI totiž může vytvořit správnou odpověď ze špatného dokumentu. A v takovém okamžiku důvěra rychle mizí.
Bezpečná AI pracující s firemními znalostmi proto stojí na několika základních principech: používat pouze schválené zdroje, každému zdroji přiřadit vlastníka, respektovat přístupová oprávnění uživatele, pracovat pouze s aktuální verzí a u každé odpovědi uvádět zdroje.
Technicky jde o retrieval-grounded generation. Schválené dokumenty jsou uložené v dokumentovém úložišti s vektorovým indexem, systém vyhledá relevantní pasáže a odpověď vždy propojí s konkrétními podklady. Tím se z odpovědi, která pouze působí věrohodně, stává odpověď, kterou lze obhájit.
Co vidíme v praxi
Nejtěžší částí práce s dokumenty v AI je málokdy samotné vyhledávání.
Je to zjištění, kolik zdrojů pravdy je zastaralých, duplicitních nebo nemá žádného vlastníka.
AI tento problém nevytváří. Jen ho činí nemožným ignorovat.
9. Nikdo ve skutečnosti neví, jestli AI odpovídá a doručuje dobře
Zeptejte se většiny týmů, jak dobře jejich AI funguje, a často dostanete dojem místo měření: „Vypadá to dobře.“ To ale není kontrolní mechanismus.
Právě tak postupně proklouznou problémy: odpověď mimo téma, tvrzení bez zdroje nebo informace, kterou daný uživatel vůbec neměl vidět. A nikdo si toho nevšimne, dokud problém jako první neobjeví zákazník nebo auditor.
Měřit kvalitu přitom není tak složité. Sestavte sadu dvaceti až padesáti skutečných otázek z reálného používání a každou odpověď vyhodnocujte podle tří kritérií: je relevantní, opírá se o konkrétní zdroj a respektuje oprávnění uživatele? Test zopakujte pokaždé, když změníte zdroje nebo proces.
Vedle toho sledujte několik provozních signálů: jak často AI eskaluje požadavek na člověka, jak často odpověď nenajde a kolik odpovědí obsahuje citaci zdroje. Cílem není perfektní skóre. Cílem je mít dostatek důkazů pro rozhodnutí: tohle můžeme škálovat, tohle musíme upravit a tohle bychom měli zastavit.
10. AI patří všem. Takže za ni neodpovídá nikdo.
Poslední signál často rozhoduje o tom, zda se podaří vyřešit i těch předchozích devět. Pokud AI use case nemá vlastníka a každý scénář prochází stejným procesem, firma obvykle skončí v jednom ze dvou extrémů: buď je příliš opatrná na to, aby cokoli nasadila, nebo příliš benevolentní na to, aby AI používala bezpečně.
Stejný asistent může být téměř bez rizika při sumarizaci interního FAQ a zároveň představovat podstatně větší problém ve chvíli, kdy připravuje výstup, podle kterého se rozhoduje zákazník. Přesto firmy často oba případy řídí stejně.
Dobře nastavená AI governance není byrokracie. Je to mechanismus, který umožňuje AI rozšiřovat bez zbytečného strachu. Praktický přístup může být relativně jednoduchý: každý use case musí mít vlastníka, jasně definovanou úroveň rizika a kontrolní mechanismy odpovídající tomuto riziku. Nízkorizikové scénáře mohou běžet automaticky, pokud existuje záznam o jejich činnosti. U rizikovějších případů přidejte lidskou kontrolu, omezené zdroje a jasný eskalační proces.
Pod tím vším stačí pět základů: vlastník, schválené zdroje, přístupová pravidla, auditní stopa a proces pro řešení incidentů. Smyslem není AI zpomalovat. Naopak. Cílem je vytvořit takové podmínky, aby ji firma mohla rozšiřovat s dostatečnou kontrolou a důvěrou.
Jak náš systém AI bojuje proti podvodům v mezinárodní přepravě
BigHub má dlouhodobé partnerství s významnou mezinárodní logistickou firmou, během níž úspěšně realizovala rozmanitou škálu datových projektů. Tyto projekty zahrnovaly celou řadu oblastí, včetně datového inženýrství, zpracování dat v reálném čase, cloudu a aplikací založených na strojovém učení, které byly navrženy a vyvinuty s cílem zlepšit provoz logistických společností, včetně správy skladu, optimalizace dodavatelského řetězce a přepravy tisíců balíků po celém světě denně.
V roce 2022 byla BigHub postavena před novou výzvu: pomoci při implementaci systému včasného odhalování podezřelých podvodných zásilek vstupujících do logistické sítě společnosti. Na základě pilotního řešení klienta, které bylo vyvinuto a testováno na základě historických dat, BigHub vylepšil algoritmy a nasadil je do výrobního prostředí pro vyhodnocování zásilek v reálném čase při vstupu do přepravní sítě. Počáteční pilotní řešení bylo založeno na dávkovém vyhodnocení, ale požadavkem pro náš tým bylo vytvoření REST API, které by zvládlo jednotlivé dotazy s dobou odezvy kratší než 200 milisekund. Toto API by bylo připojeno k síti klienta, kde by na datech byly prováděny další operace.

Navrhovaná aplikace je navržena s architekturou na vysoké úrovni, jak je znázorněno na doprovodném diagramu. Jádrem systému je REST API, které je připojeno k síti klienta pro příjem a zpracování dotazů. Tyto dotazy podléhají ověření a vyhodnocení, přičemž výsledky se pak vrátí koncovému uživateli. Datová vrstva slouží jako základ pro výpočty, stejně jako pro trénink modelů a předzpracování tabulek prvků. Výsledky hodnocení jsou také uloženy v datové vrstvě, aby se usnadnilo vytváření souhrnných analýz ve vrstvě vykazování. Vrstva MLops spravuje životní cyklus modelu strojového učení, včetně školení, validace, ukládání metrik pro každou verzi modelu a zpřístupnění aktuální verze modelu prostřednictvím rozhraní REST API. K dosažení tohoto cíle celé řešení využívá celou řadu moderních datových technologií, včetně Kubernetes, MLFlow, AirFlow, Teradata, Redis a Tableau.
Během vývoje systému potřeboval náš tým řešit několik výzev, mezi které patří:
- Nastavení a škálování REST API pro zpracování velkého objemu dotazů (260 dotazů z 30 paralelních zdrojů za sekundu) v reálném čase, což zajišťuje jeho připravenost pro globální nasazení.
- Optimalizace rychlosti vyhodnocování jednotlivých dotazů pomocí nízkoúrovňových programovacích technik ke zkrácení času ze stovek milisekund na desítky milisekund.
- Správa životního cyklu modelu strojového učení, včetně automatizovaného rekvalifikace, nasazení nových verzí do API, monitorování kvality a oznámení, pro zajištění spolehlivého dlouhodobého výkonu.
- Implementace úprav v běhu - náš agilní přístup zajistil flexibilitu a umožnil rychlé a úspěšné změny probíhajícího projektu pro spokojenost obou stran a lepší výsledky.
BigHub je hrdým partnerem DATA Mesh
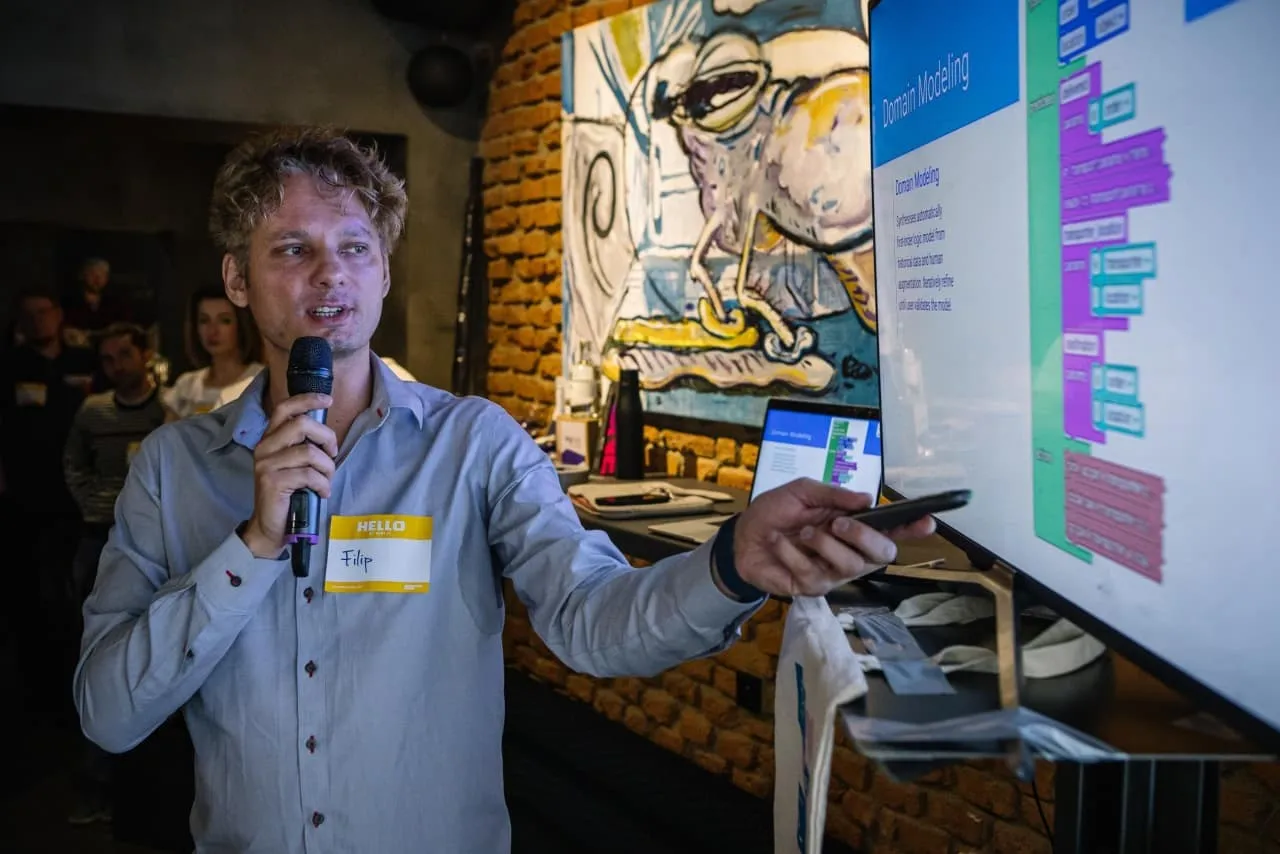
Neformální pravidelné setkání plné nejnovějších drbů o datech, kde se můžete zúčastnit přednášek od kohokoli, kdo miluje data - od legendárních zakladatelů startupů až po juniorské datové nadšence. Mluvíme o DATA Mesh setkání, jehož jsme partnerem.
„Hledali jsme místo, kde bychom se mohli neformálně setkat, diskutovat a sdílet mezi sebou zkušenosti ze zajímavých projektů. Proto jsme se rozhodli pořádat pravidelná datová setkání, „říká Karel Šimánek, generální ředitel BigHub a jeden z organizátorů a zakladatelů DATA Mesh.
Setkání se koná každý měsíc v klubu K7 v pražských Vršovicích a návštěvníci si mohou užít krátké, ale inspirativní prezentace z různých oborů s lidmi, kteří mají skutečné zkušenosti s daty a ML aplikacemi. Samozřejmostí je i afterparty, kde si můžete navázat skvělé kontakty a zahrát si legendární hru Atomic Bomberman za úžasné ceny.
Celkem proběhlo již pět setkání s hosty, jako jsou Sarah Polak, Jan Kučera z Datamole, Lukáš Jelínek z Pocket Virtuality nebo Jan Šindera z Nano Energies.

BigHub v TOP10 v soutěži Deloitte Technology Fast 50 CE 2021
Desátá ve střední Evropě a šestá v České republice. To jsou výsledky soutěže Deloitte Technology Fast 50 CE 2021, která porovnává růst registrovaných technologických společností za předchozí čtyři roky, od roku 2017 do roku 2020. V letošním roce se do CE Top 50 dostalo 19 firem z České republiky, mezi první desítkou vítězů patřily FTMO, DoDo, Driveto nebo DataSentics a náš BigHub! byl jedním z nich. Jsme velmi vděční, že jsme zařazeni mezi takové skvělé společnosti.
S celkovým růstem o 1 795% uzavíráme první desítku společností v CE. Kromě toho se letos přihlásilo 139 lokálních firem, takže bylo možné sestavit žebříček 50 nejlepších českých technologických firem, kde jsme skončili na šestém místě.“Zkušenosti z minulých let ukazují, že díky programu Fast 50 se firmám daří najít zajímavé příležitosti, změnit své způsoby a dále růst,“ říká Jiří Sauer, vedoucí programu CE Technology Fast 50.
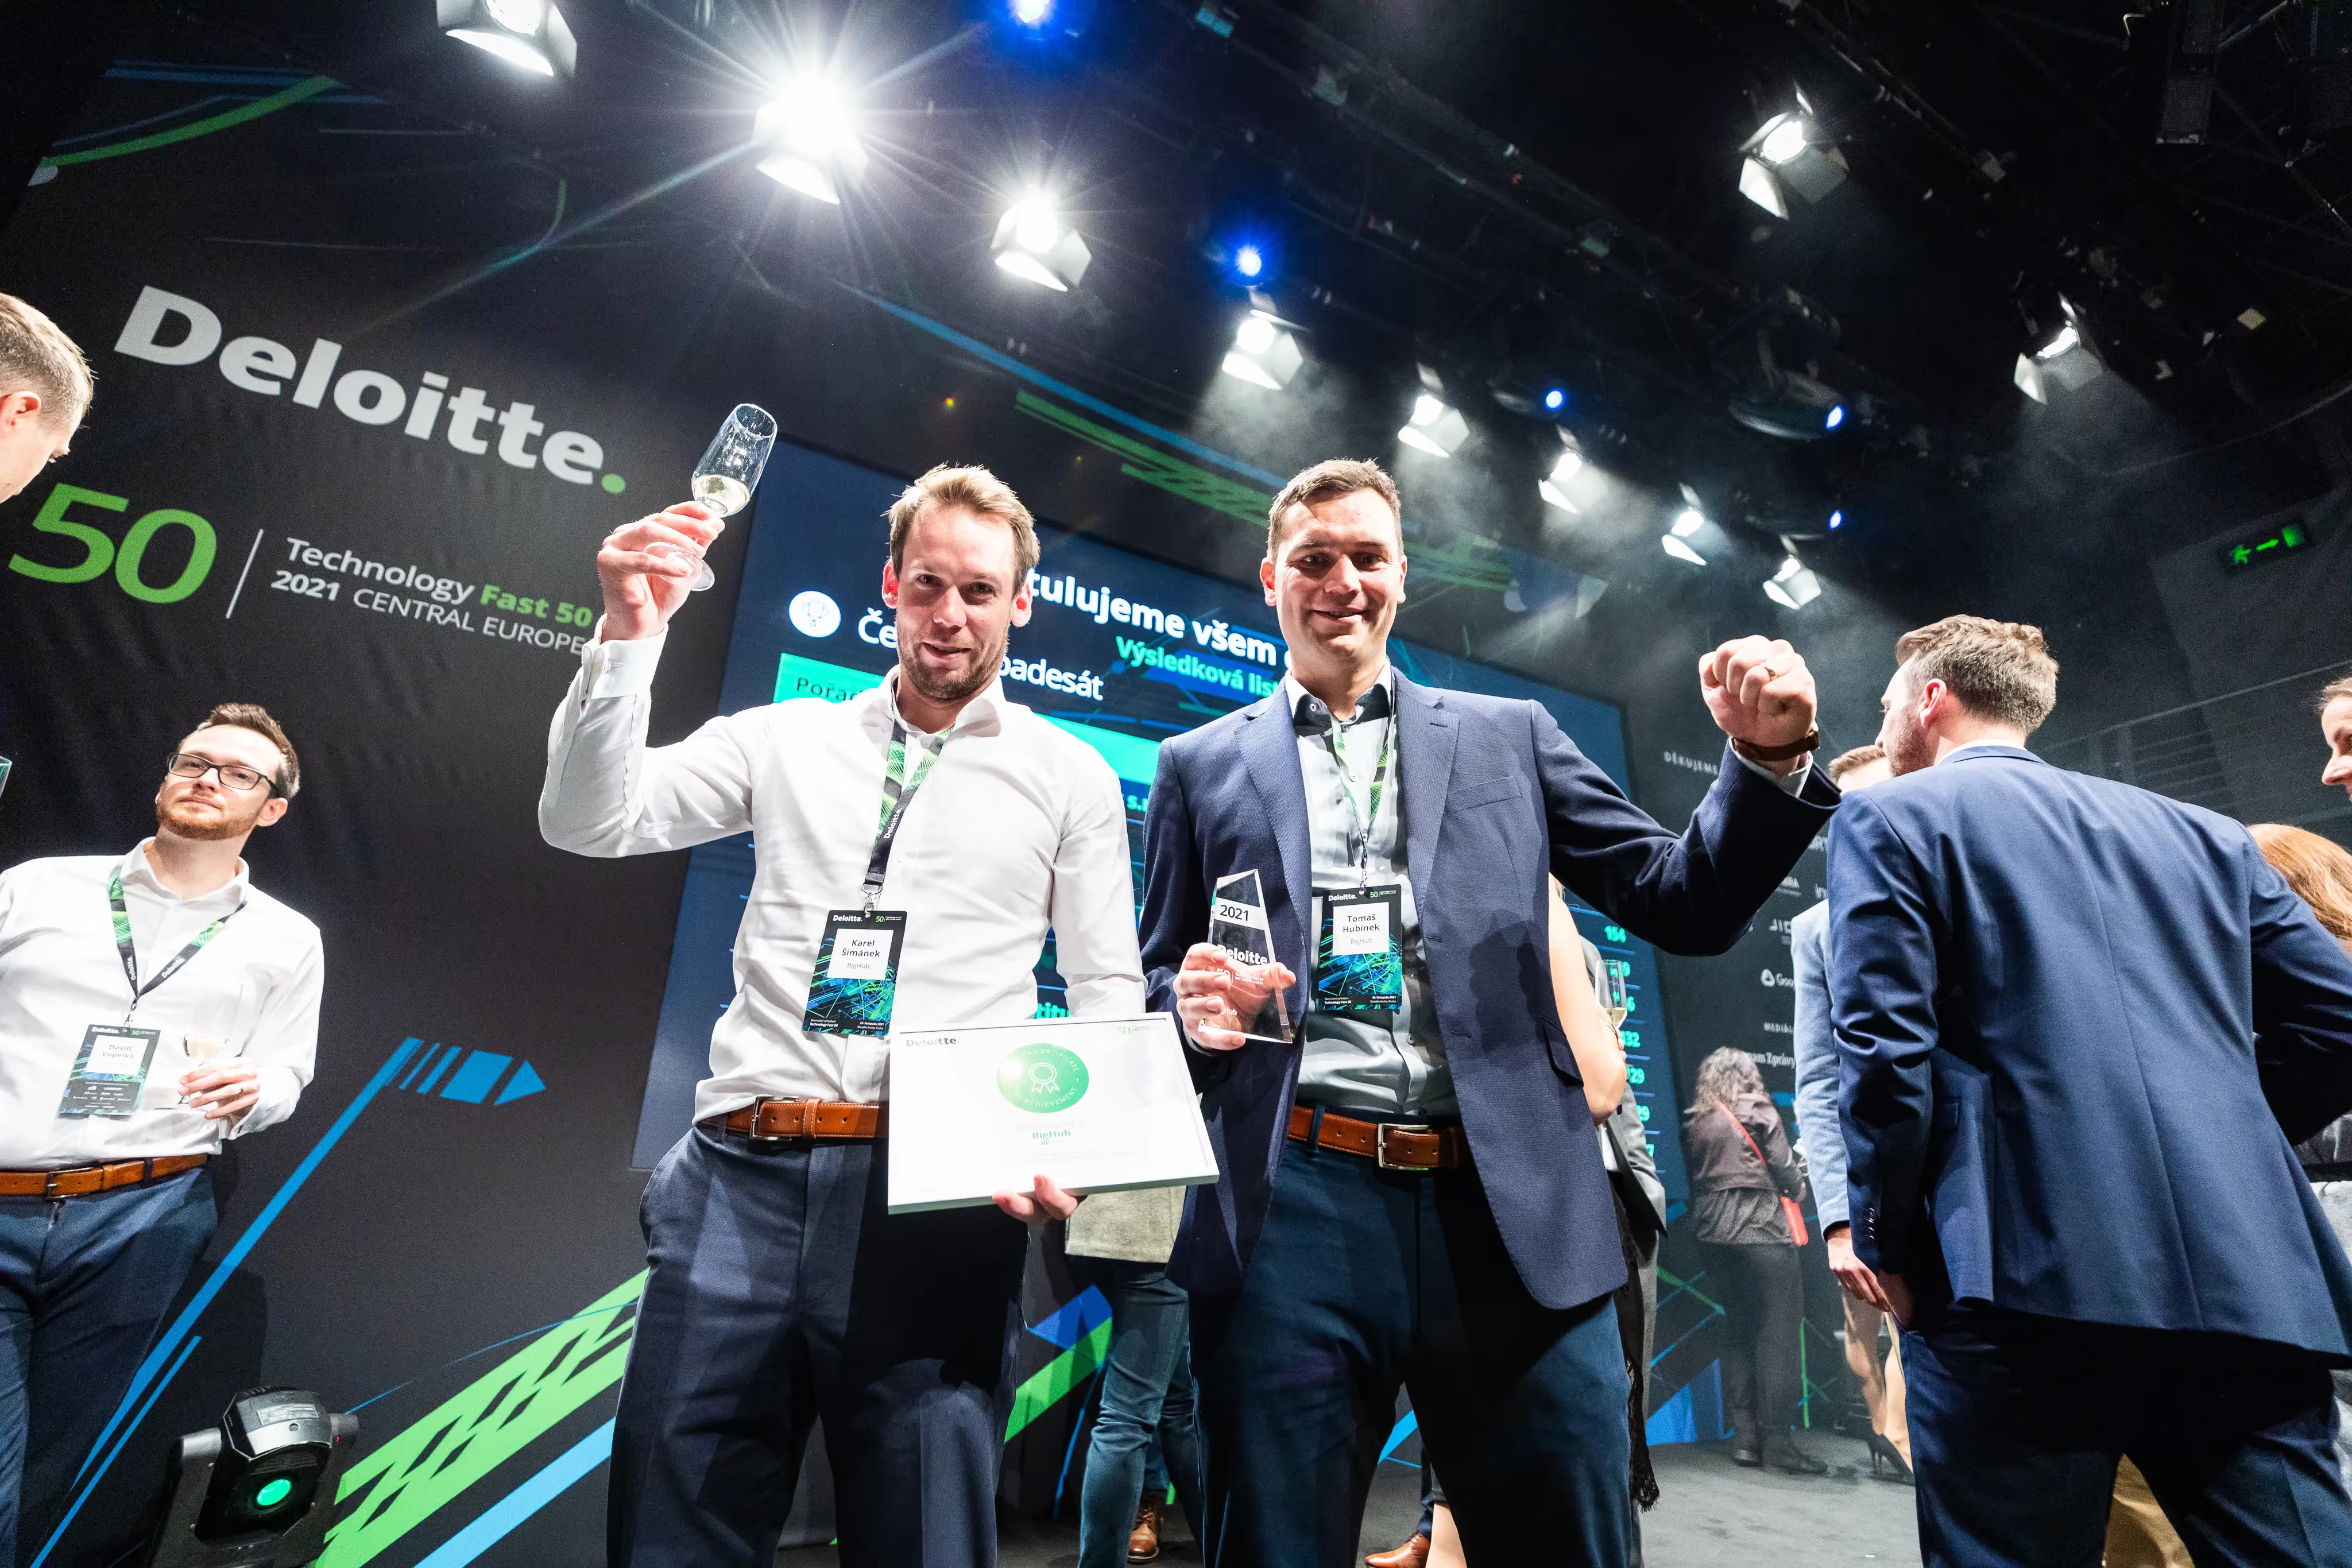
Dominanci české technologické scény nebylo možné přehlédnout. Máme 6 zástupců v evropské top 10 a 19 domácích technologických lídrů v evropské top 50. Letošní ročník zároveň zaznamenal nejvyšší růst, přičemž průměrný počet registrovaných společností vzrostl o 2 278%.
Slavnostní ceremoniál se konal v Divadle Archa a večer moderoval Tomáš Studeník. Všechny české a středoevropské společnosti, které byly oceněny v programu Deloitte Technology Fast 50, najdete na tomto stránka.
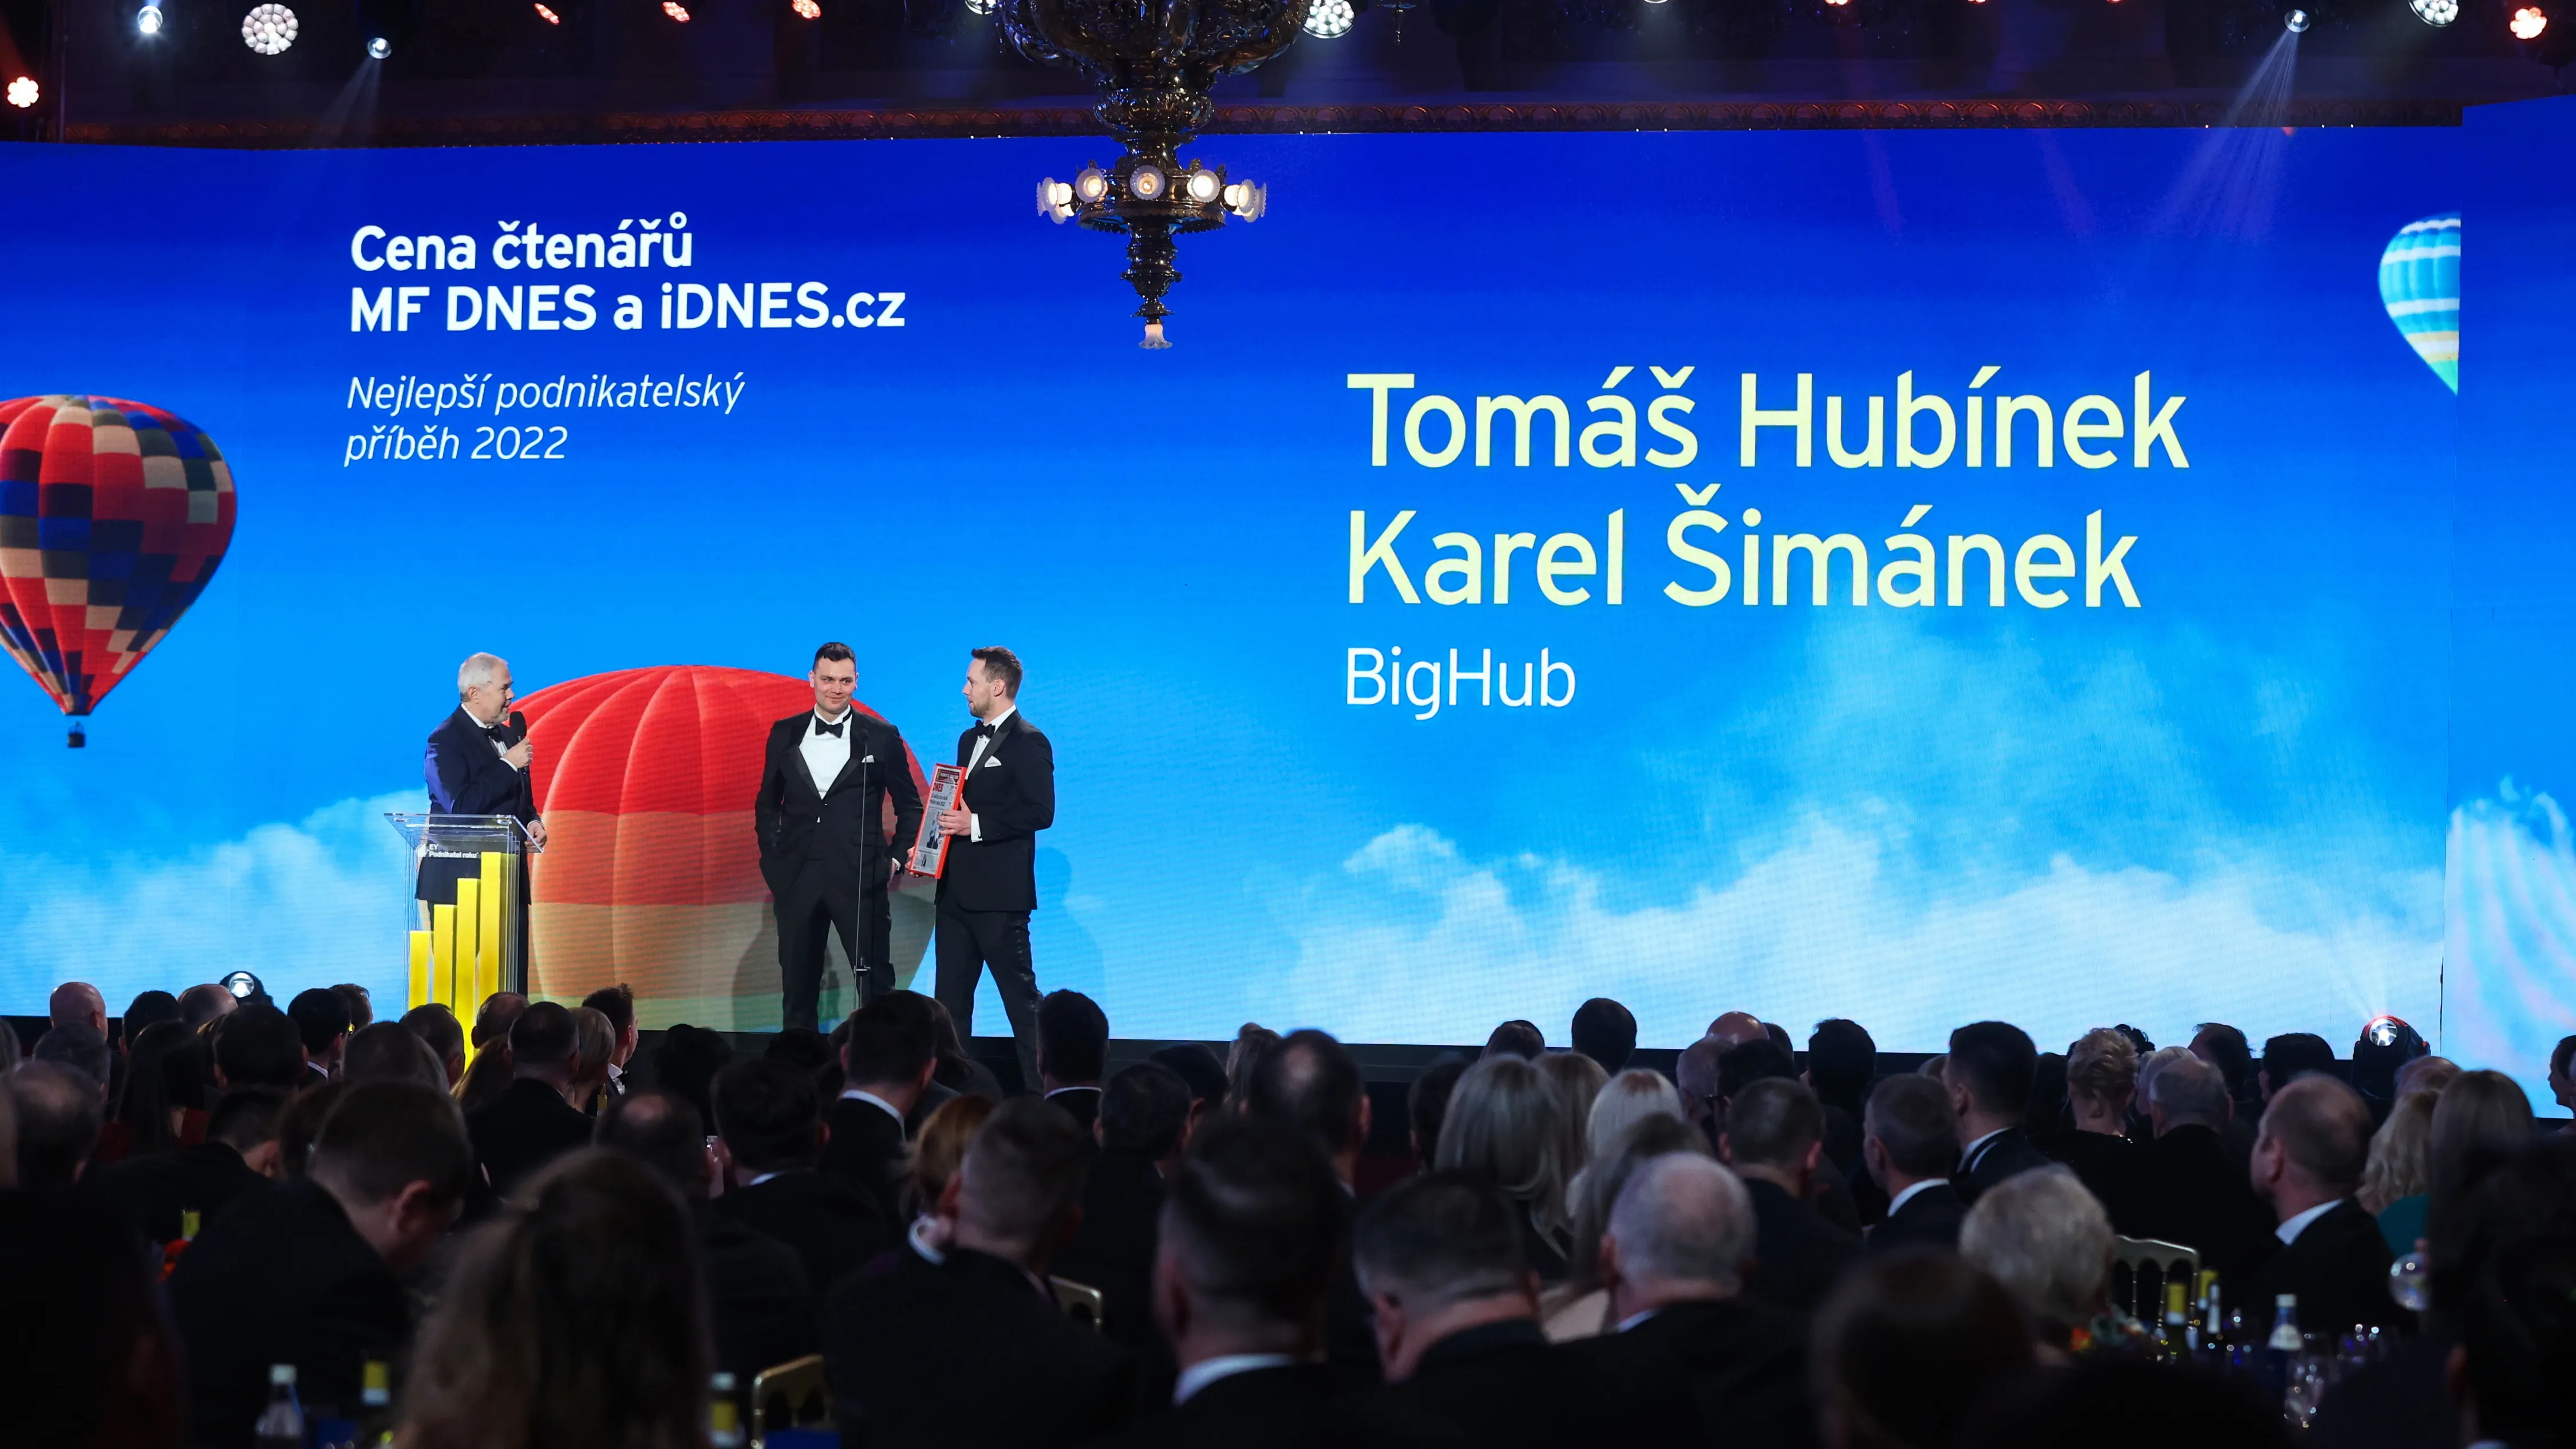
BigHub získal ocenění Cenu Čtenářů za nejlepší obchodní příběh v soutěži EY Podnikatel roku
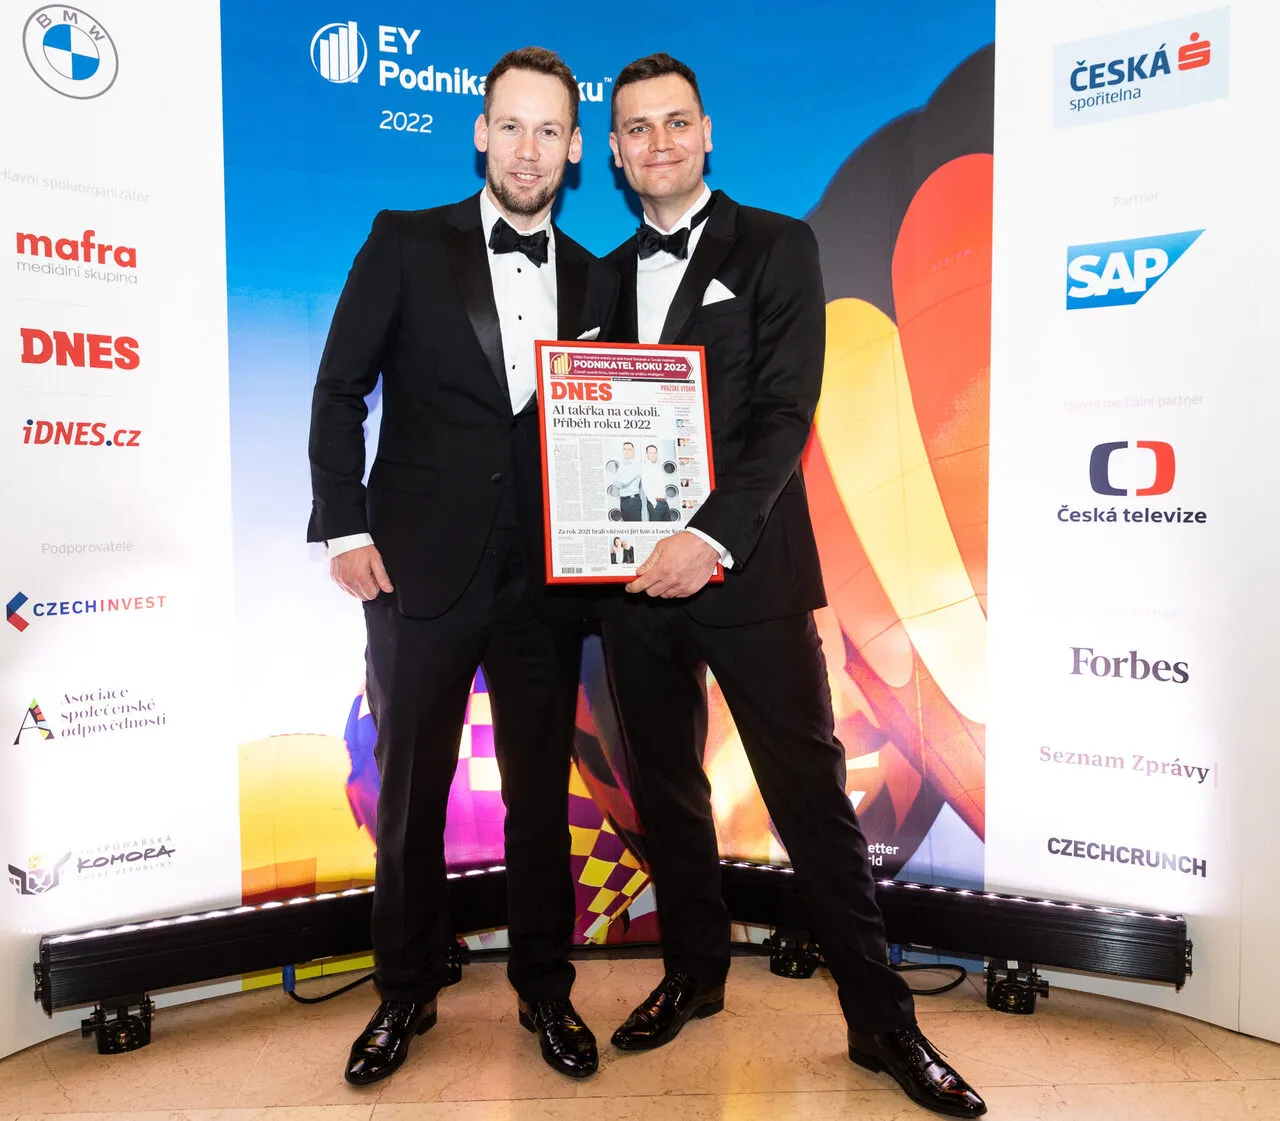
Tomáš Hubínek a Karel Šimánek založili technologickou společnost BigHub, která se specializuje na aplikovanou umělou inteligenci. Jejich sada dovedností a technologie má několik aplikací, od předpovídání fluktuace zaměstnanců až po detekci krádeží elektřiny.
Setkali se během studia na Českém vysokém učení technickém v Praze. Oba pracovali v poradenských a bankovních firmách, než si uvědomili nevyužitý potenciál AI v podnikání. To vše vedlo k založení BigHub v roce 2016, která je od svého vzniku zisková a je na dobré cestě k obratu 100 milionů korun.
Jejich příběh získal pozornost a uznání čtenářů Mladé fronty a iDNES.cz. Čtenáři ocenili BigHub Cena čtenářů za nejlepší obchodní příběh v soutěži EY Podnikatel roku, celosvětově uznávané soutěže pro podnikatele založené EY v roce 1986.
Detekce a predikce od BigHub
Práce společnosti BigHub pokrývá řadu průmyslových odvětví, včetně energetiky, logistiky, maloobchodu a lidských zdrojů. Technologie neuronových sítí BigHub pomáhá detekovat nežádoucí vibrace v turbínách jaderné elektrárny Temelín a předpovídá poruchy zařízení na čerpacích stanicích, nebo se podílel na vývoji a implementaci systém včasné detekce pro identifikaci podvodných zásilek vstupujících do logistické sítě.
„Letošní vítězové nám již ukazují prostředí, ve kterém bude lidský druh brzy existovat. Představují také budoucnost špičkových IT byznysů, kde se Češi tradičně prosazují v nejsilnější světové konkurenci. Věřím, že takový úspěch čeká BigHuba Tomáše Hubínka i Karla Šimánka a blahopřeji oběma párům k vítězství, „řekl Jaroslav Plesl, šéfredaktor MF DNES, vítězům Ceny čtenářů.
Další oblastí, kde by BigHub rád pomohl, je zdravotní péče, kde může pomoci umělá inteligence. „Mám rád projekty, které mají dopad a medicína je oblast, kde může být AI velmi užitečnál, „připouští Hubínek.
Neustálé sledování trendů AI
Kromě své práce v BigHub se Tomáš a Karel aktivně podílejí na různých iniciativách na podporu a podporu rozvoje technologie AI a talentovaných studentů. Oba jsou lektory na Českém vysokém učení technickém v Praze a na středních školách a věnují se tomu, aby byli v obraze s nejnovějšími trendy AI.
Organizují také pravidelná setkání pro profesionály z oboru napříč společnostmi, aby se mohli propojit a sdílet své odborné znalosti a zapojit se do datového podcastu, který poskytuje bystré rozhovory na odborná témata z české a slovenské datové scény. Dále podporují Cenu Josefa Hlávky, která oceňuje a odměňuje talentované studenty.

Napište si o nezávaznou konzultaci zdarma
Chcete s námi probrat podrobnosti? Vyplňte krátký formulář níže a my se vám brzy ozveme, abychom si s vámi domluvili termín nezávazné online konzultace zdarma.
